目錄
最近,OpenAI 開發者部落格發了一篇文章:Rethinking skills and prompts for GPT-6 Astra。文章的建議可以概括為:在使用 GPT-6 Astra 時,重新檢查 AGENTS.md 裡的每一條指令是否還需要,把 Skill 的描述寫到儘量短、只說明什麼時候該用;過去那種保姆式的繁複微操,不必再照搬。
但如果你像我一樣,平時並不是把 GPT-6 當成唯一的日常主力,而是日常開發主要用 Sol 和 Luna,盲目照搬官方建議、把本機規則「一刀切全刪光」,很可能會讓其他模型因為缺乏指引而出現明顯的執行偏差。
如何在用上新一代模型能力的同時,兼顧多模型的穩定性?
這篇文章,我結合自己近期的實操記錄、三模型分流策略和 Codex 裡的本機規則,梳理一遍哪些要刪、哪些要留。
一、為什麼文章建議給 GPT-6 提示詞做減法?
我理解這篇博文的核心論點是:當底層模型的長程規劃和自主驗證能力明顯提升後,過去為了防止模型「降智」而寫下的繁複微操規則,反而可能變成干擾。
在 5.6 或更早的模型階段,大模型在複雜任務中容易出現發散、遺忘或執行偏差。為了讓 Agent 穩定工作,開發者們習慣在 AGENTS.md、系統提示詞和各種 Skills 裡塞入很詳細的步驟指令:從每一步的思考步驟、參數規範、異常處理,到冗長的格式約束。
在 GPT-6 Astra 這一代模型上,繼續堆疊這些規則,我判斷會帶來三個問題。下面三點是我的判斷,不是原文的結論,我也沒有統計過 Token 消耗:
- 佔用上下文:規則佔據視窗,留給實際程式碼和業務上下文的空間就少了;
- 引發不必要的測試:文章的意思是,Astra 本身就會主動驗證。如果規則裡反覆催促「必須執行測試」,就可能導致重複測試。後文 Skill 裡「程式碼沒變也要重跑」的要求,就是這一類;
- 過度約束:過細的流程會剝奪模型動態探索和自我糾錯的空間。
這個「給規則做減法」的趨勢並不是突然出現的:
- 5.6 時期,Agent 降智的討論剛出來時,我寫過上下兩篇文章,講規則過載怎樣擠佔上下文、拖累模型的執行與推理。當時我就建議對
AGENTS.md和 Skills 做極簡瘦身和分層治理。 - GPT-6 發布後的實測:我把 GPT-6 當預設模型用了兩天,又把 Codex 改回了 Sol/Medium,還為此寫過一篇評測。我的一句判斷是:GPT-6 的自主規劃與推理已經很成熟,別把模型當傻子教。開工第一步不是給它寫一堆微操規則,而是先讓它審視本機環境,把阻礙它發揮的冗餘流程砍掉。
- 另外,Anthropic 為 Claude Fable 5 寫的提示詞指南(2026 年 10 月核對)也有類似思路。它建議寫清請求背後的目的,用簡短指令代替逐條規定行為;它還提醒,為舊模型寫的 Skill 往往過於死板,可能反而拖累輸出品質。
二、千萬別一刀切:多模型環境下的規則分流
這篇文章主要討論 GPT-6 Astra。它也提醒,同一個倉庫裡的規則會被不同模型讀取,給 Sol、Luna 寫的指引,可能會把 Astra 約束得太細。
以我自己的日常工作流為例:在 VibeCoding 開發中,我的主力模型是以 Sol 和 Luna 為基準,在需要架構重構、複雜演算法或深度推理時才切換到 GPT-6 Astra。所以只按 Astra 刪規則不夠,還要照顧另外兩個模型。
我設計的是一套「向下相容、向上釋放」的分流方式:
| 適用範圍 | 核心策略與實施方案 | 避坑重點 |
|---|---|---|
| 所有模型共用基準 | 清理重複冗餘要求;準確收緊 Skills 的觸發範圍;按需載入文件;以真實產物為準檢查。 | 同一條要求只維護一處,避免多處規則互相打架。 |
| Sol / Luna 主力工作流 | 保留簡短但必要的執行步驟、驗收清單(Checklist)、失敗兜底處理與核心安全邊界。 | 保持輕量可控,不堆砌長篇理論。 |
| GPT-6 Astra 任務 | 在明確授權範圍內持續做到驗收完成;減少固定步驟的逐輪停頓和重複驗證。 | 寫清完成條件和退出條件,避免首次實現後就停下來等指令。 |
三、針對 3D 與視覺任務的一段提示詞
在前端頁面、3D 渲染或影片編輯這類任務裡,Vaibhav Srivastav(X 帳號 @reach_vb)分享過一段提示詞。他的說法是,讓模型在工作中驗證自己的產物,能顯著提升最終成品的品質。這是他的個人經驗,我沒有獨立測試過。
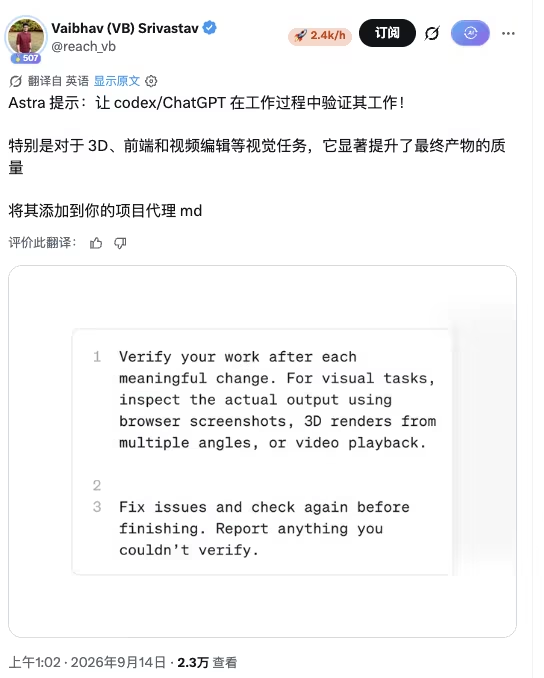 ▲ Vaibhav Srivastav(@reach_vb)在 X 上分享的視覺任務驗證提示語
提示詞英文原文如下,與截圖一致:
Verify your work after each meaningful change. For visual tasks, inspect the actual output using browser screenshots, 3D renders from multiple angles, or video playback.

Fix issues and check again before finishing. Report anything you couldn't verify.
把這段提示詞加入專案的 AGENTS.md,是要求模型在交付視覺產物前檢查實際輸出,而不只是確認程式碼寫完了。模型是否真的照做,還是要看留下的截圖、渲染或播放檢查結果。
四、實操:把官方文章交給 Codex,檢查本機 AGENTS.md
與其憑空猜測,不如直接讓 AI 看自己的規則。我的做法是把 OpenAI 的博文連結發給 Codex,並說明多模型的使用情況。那次用的是 GPT-6 Astra 中推理(2026 年 9 月實測)。
我的提問大意是:Astra 不是我主要用的模型,我主要用的是 Sol 和 Luna,請結合這篇文章看看 AGENTS.md 和 Skills 該怎麼調整;如果用 Astra,再加上 OpenAI 開發者建議的那段視覺驗證提示語。
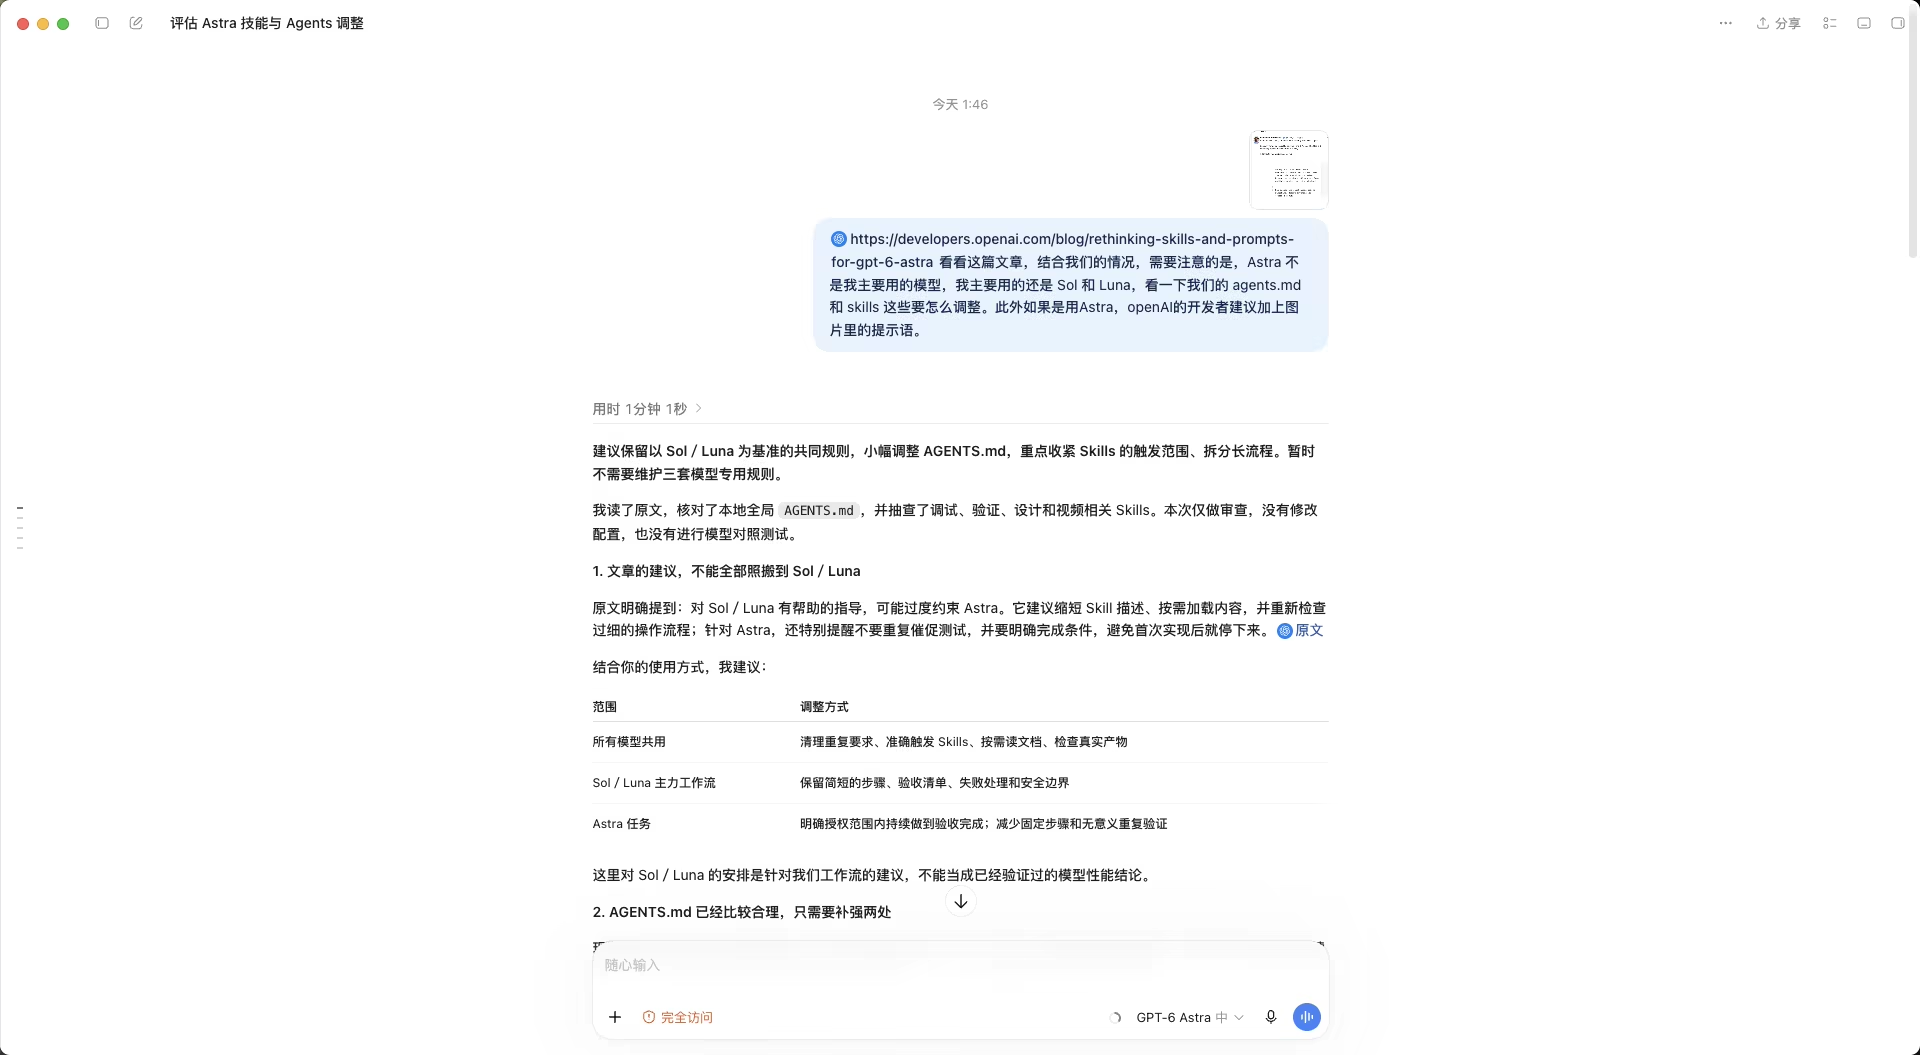 ▲ 在 Codex 中,把官方文章和本機多模型使用情況一起交給它審查
Codex 讀了原文,核對了本機全域 AGENTS.md,並抽查了除錯、驗證、設計和影片相關的幾個 Skill。這次它只做審查,沒有修改設定,也沒有做模型對照測試。它的結論是:現有 AGENTS.md 已經比較合理,以 Sol、Luna 為基準的共同規則可以保留,小幅調整即可,暫時不必為三個模型各維護一套規則。它也說明,對 Sol、Luna 的安排是針對我們工作流的建議,不能當成已經驗證過的模型效能結論。
Git 防護、生產資料隔離、使用者授權和改動保護這些邊界應該保留,不能因為換用 Astra 就刪掉。Codex 建議的是合併和調整現有條款,而不是再追加一大段重複內容。它給出的主要是兩處改動,下面是它的措辭:
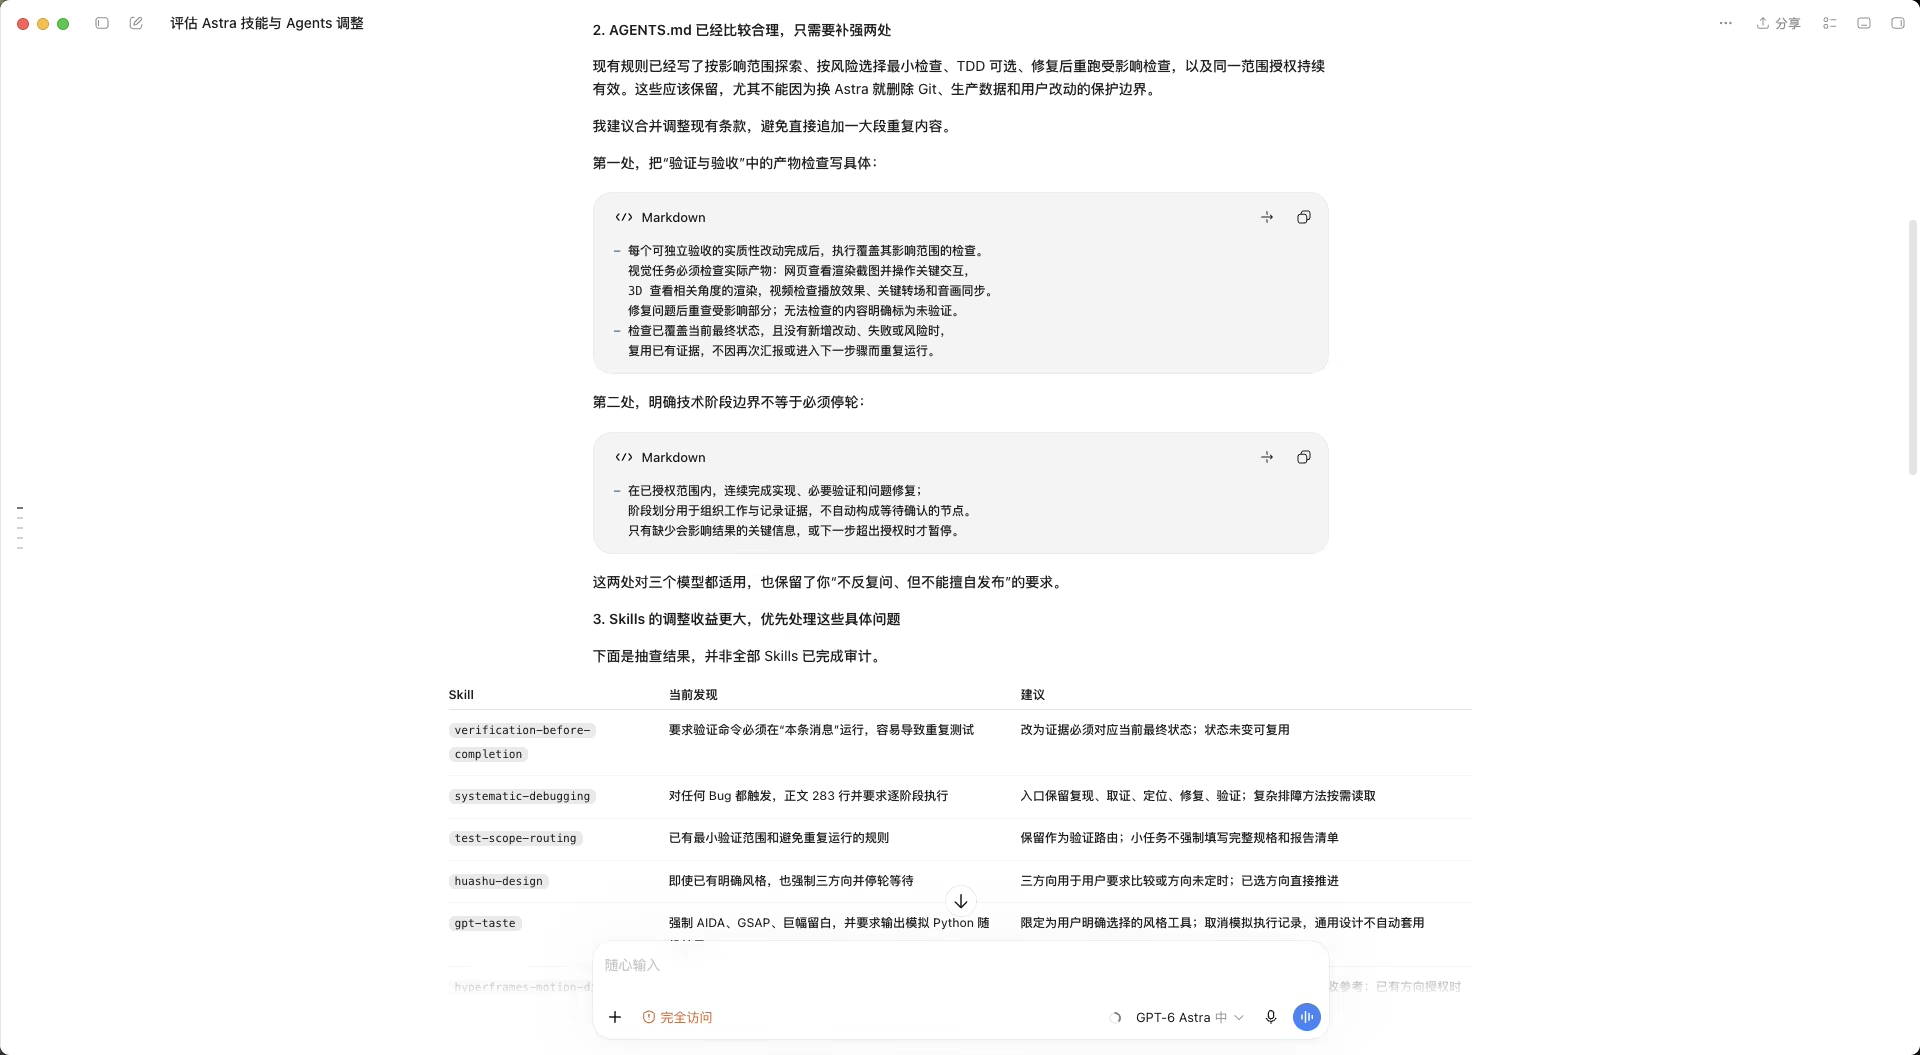 ▲ Codex 給出的產物檢查與階段推進調整建議
第一處:產物檢查與證據複用
- 每个可独立验收的实质性改动完成后,执行覆盖其影响范围的检查。视觉任务必须检查实际产物:网页查看渲染截图并操作关键交互,3D 查看相关角度的渲染,视频检查播放效果、关键转场和音画同步。修复问题后重查受影响部分;无法检查的内容明确标为未验证。
- 检查已覆盖当前最终状态,且没有新增改动、失败或风险时,复用已有证据,不因再次汇报或进入下一步骤而重复运行。
第二處:階段劃分不等於每輪都停下來
- 在已授权范围内,连续完成实现、必要验证和问题修复;阶段划分用于组织工作与记录证据,不自动构成等待确认的节点。只有缺少影响结果的关键信息,或下一步超出授权时才暂停。
這兩處建議我後來都寫進了全域 AGENTS.md,措辭按自己的習慣做了調整。
五、幾個具體 Skill 的問題
除了 AGENTS.md,Codex 在抽查中指出的 Skill 問題更具體。下面是它提出的問題和建議。注意,這是建議清單,並不代表全部 Skill 已經審計並修改完成。
verification-before-completion(完成前驗證)- 問題:要求驗證命令必須在「本條訊息」裡執行,容易導致程式碼沒變也要重複跑測試;
- 建議:驗證證據要對應當前最終狀態,狀態沒變時可以複用已有證據。
systematic-debugging(系統化排障)- 問題:對任何 Bug 都會觸發,正文 283 行,並要求逐階段執行;
- 建議:入口保留復現、取證、定位、修復、驗證,複雜排障方法改為按需讀取。
test-scope-routing(測試範圍路由)- 問題:已有按影響範圍選擇檢查、避免重複執行的規則,但小任務也要求填寫完整的規格和報告清單;
- 建議:保留路由思路,小任務不強制填寫完整表格。
- 設計類 Skill(
huashu-design、gpt-taste)huashu-design:即使使用者已經指定風格,仍要求給出三套方向並停下來等待選擇。建議是隻有使用者要求比較或方向未定時,才給多套方案;gpt-taste:強制使用 AIDA、GSAP、大面積留白,並要求輸出模擬 Python 隨機執行的記錄。建議是按使用者明確選擇的風格來,取消這類模擬記錄,通用設計不自動套用固定樣式。
這幾處比「把 Skill 縮短一點」更具體:完成前驗證改的是證據條件,排障改的是閱讀時機,設計類改的是何時需要給出方案。
不過,這次的結果是抽查和建議。我還沒有統計改完後少跑了多少次測試,也沒有測量 Token 節省,這些要看後續任務的實際表現。
六、總結與自檢清單
給 Agent 做減法,本質上是把人的精力從瑣碎的過程微操,轉移到目標定義、驗收標準和核心邊界上。
對照日常開發,可以檢查下面幾項:
- 提示詞瘦身:
AGENTS.md裡是否還有重複催促測試的規則? - 多模型相容:是否為 Sol、Luna 保留了簡短明確的驗收清單,而不是一刀切全刪?
- 視覺任務保障:涉及 3D、前端或影片時,是否要求模型檢查實際產物?
- 證據複用:是否把「測試命令強制重跑」改成了「產物狀態未變時複用已有證據」?
- 流程拆分:複雜 Skill 的詳細方法,是否改為按需載入?