最近不管是換用 GPT-5.6-Sol 還是各類推理模型(以下是 2026 年 8 月的使用體感),寫程式碼時反而經常覺得它反應遲鈍,而且token消耗有點大,不聽指令以及處理時間過長的事情屢見不鮮,我第一反應難道是模型降智了?但是降智的話也不應該全部模型都降智啊。
突然想起之前Claude Code 團隊的人裡提到,他們為最新一代模型刪掉了約 80% 的系統提示詞,但是表現良好。Claude Code 團隊的 Thariq 在 2026 年 7 月的推文裡寫到了這件事,並配了一篇講 Claude 5 模型上下文工程規則的文章(推文原文)。
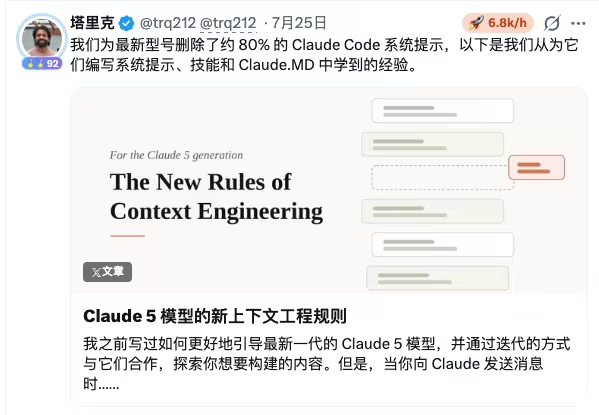
現在的harness自己就具備程式碼檢索和編輯邊界意識,用戶端的工具鏈也有底層校驗,以前手把手教的內容早就成了模型常識。
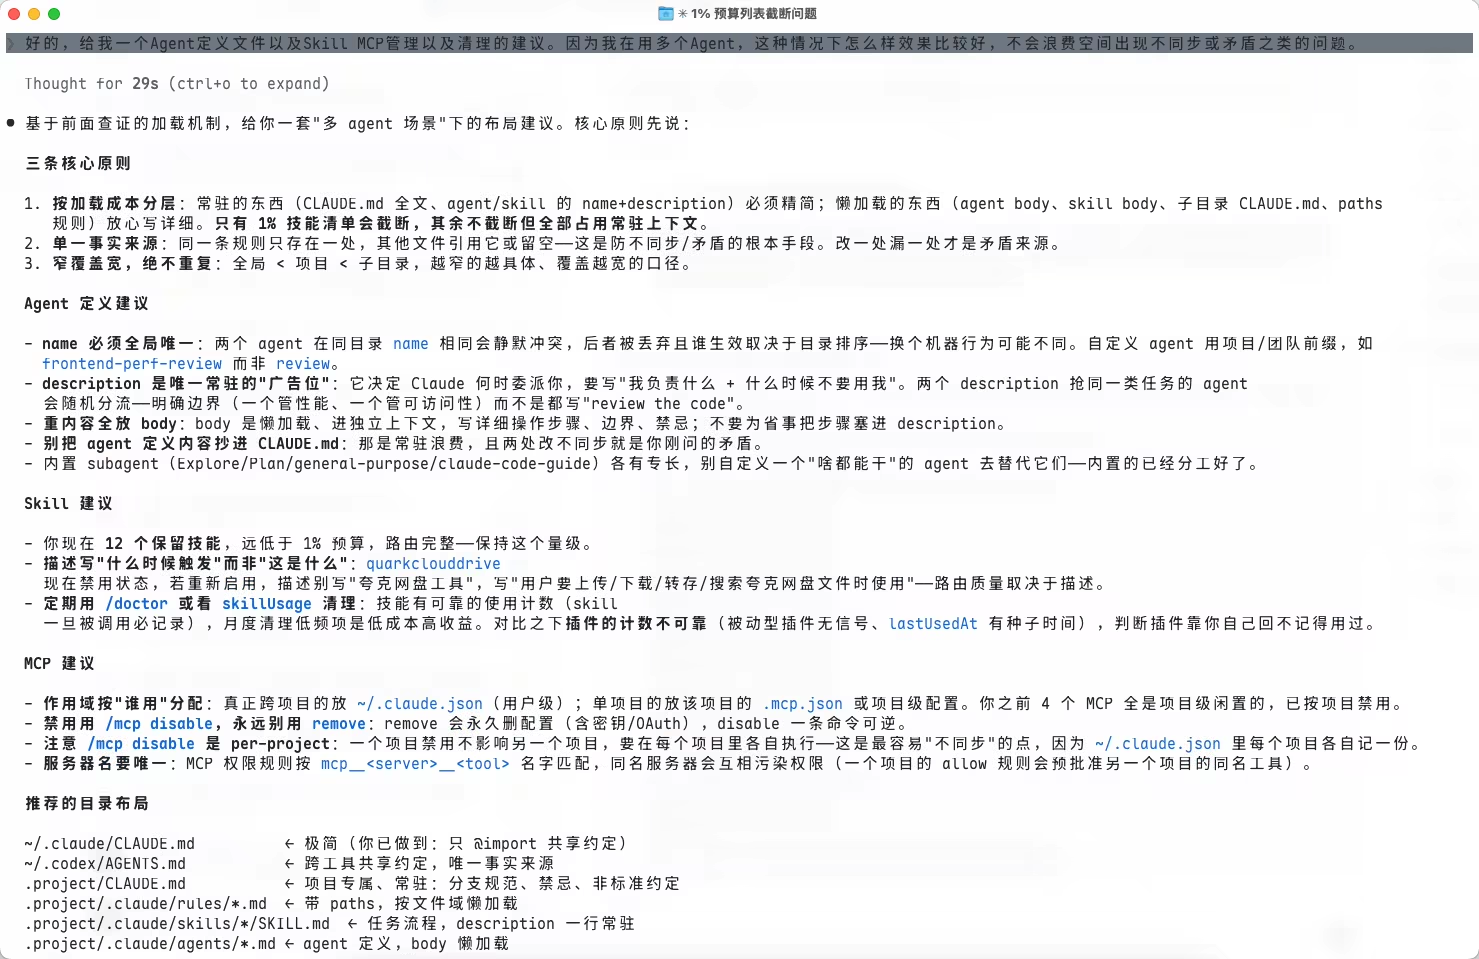
也就是說我們的CLAUDE.md 或者 AGENTS.md 不用寫那麼多提示詞,Agent 也不用裝那麼多skill、mcp和插件等工具了,很多能力都已經內化到harness裡去了,不然反而效果更差。
有的朋友可能會問什麼是harness?簡單地說它就是執行大模型的底座,包括工具使用、記憶、狀態永續性、執行環境及回饋迴路等。
現在挺流行的定義:Agent = Model + Harness。
模型越強,舊規則越像噪音
跑題了,回到正題。
翻開這些檔案看了看,其實全是我這大半年寫程式碼時慢慢攢下的。回想起來我最早用的Agent是Google Antigravity,然後是 Claude Code,最近主要是 Codex ,誰讓A➗封我號了。
每次遇到 AI 犯錯,我就習慣性在對應專案的 CLAUDE.md 或者 AGENTS.md 里加一條規矩:AI 亂改別的檔案了加一條,漏跑測試了加一條,群裡看到別人分享的所謂架構師提示詞也往裡粘。不同 Agent 的檔案不統一,有重複的也有不同的。
日積月累,全域和專案的設定檔直接變成了一本厚厚且雜亂的說明書。
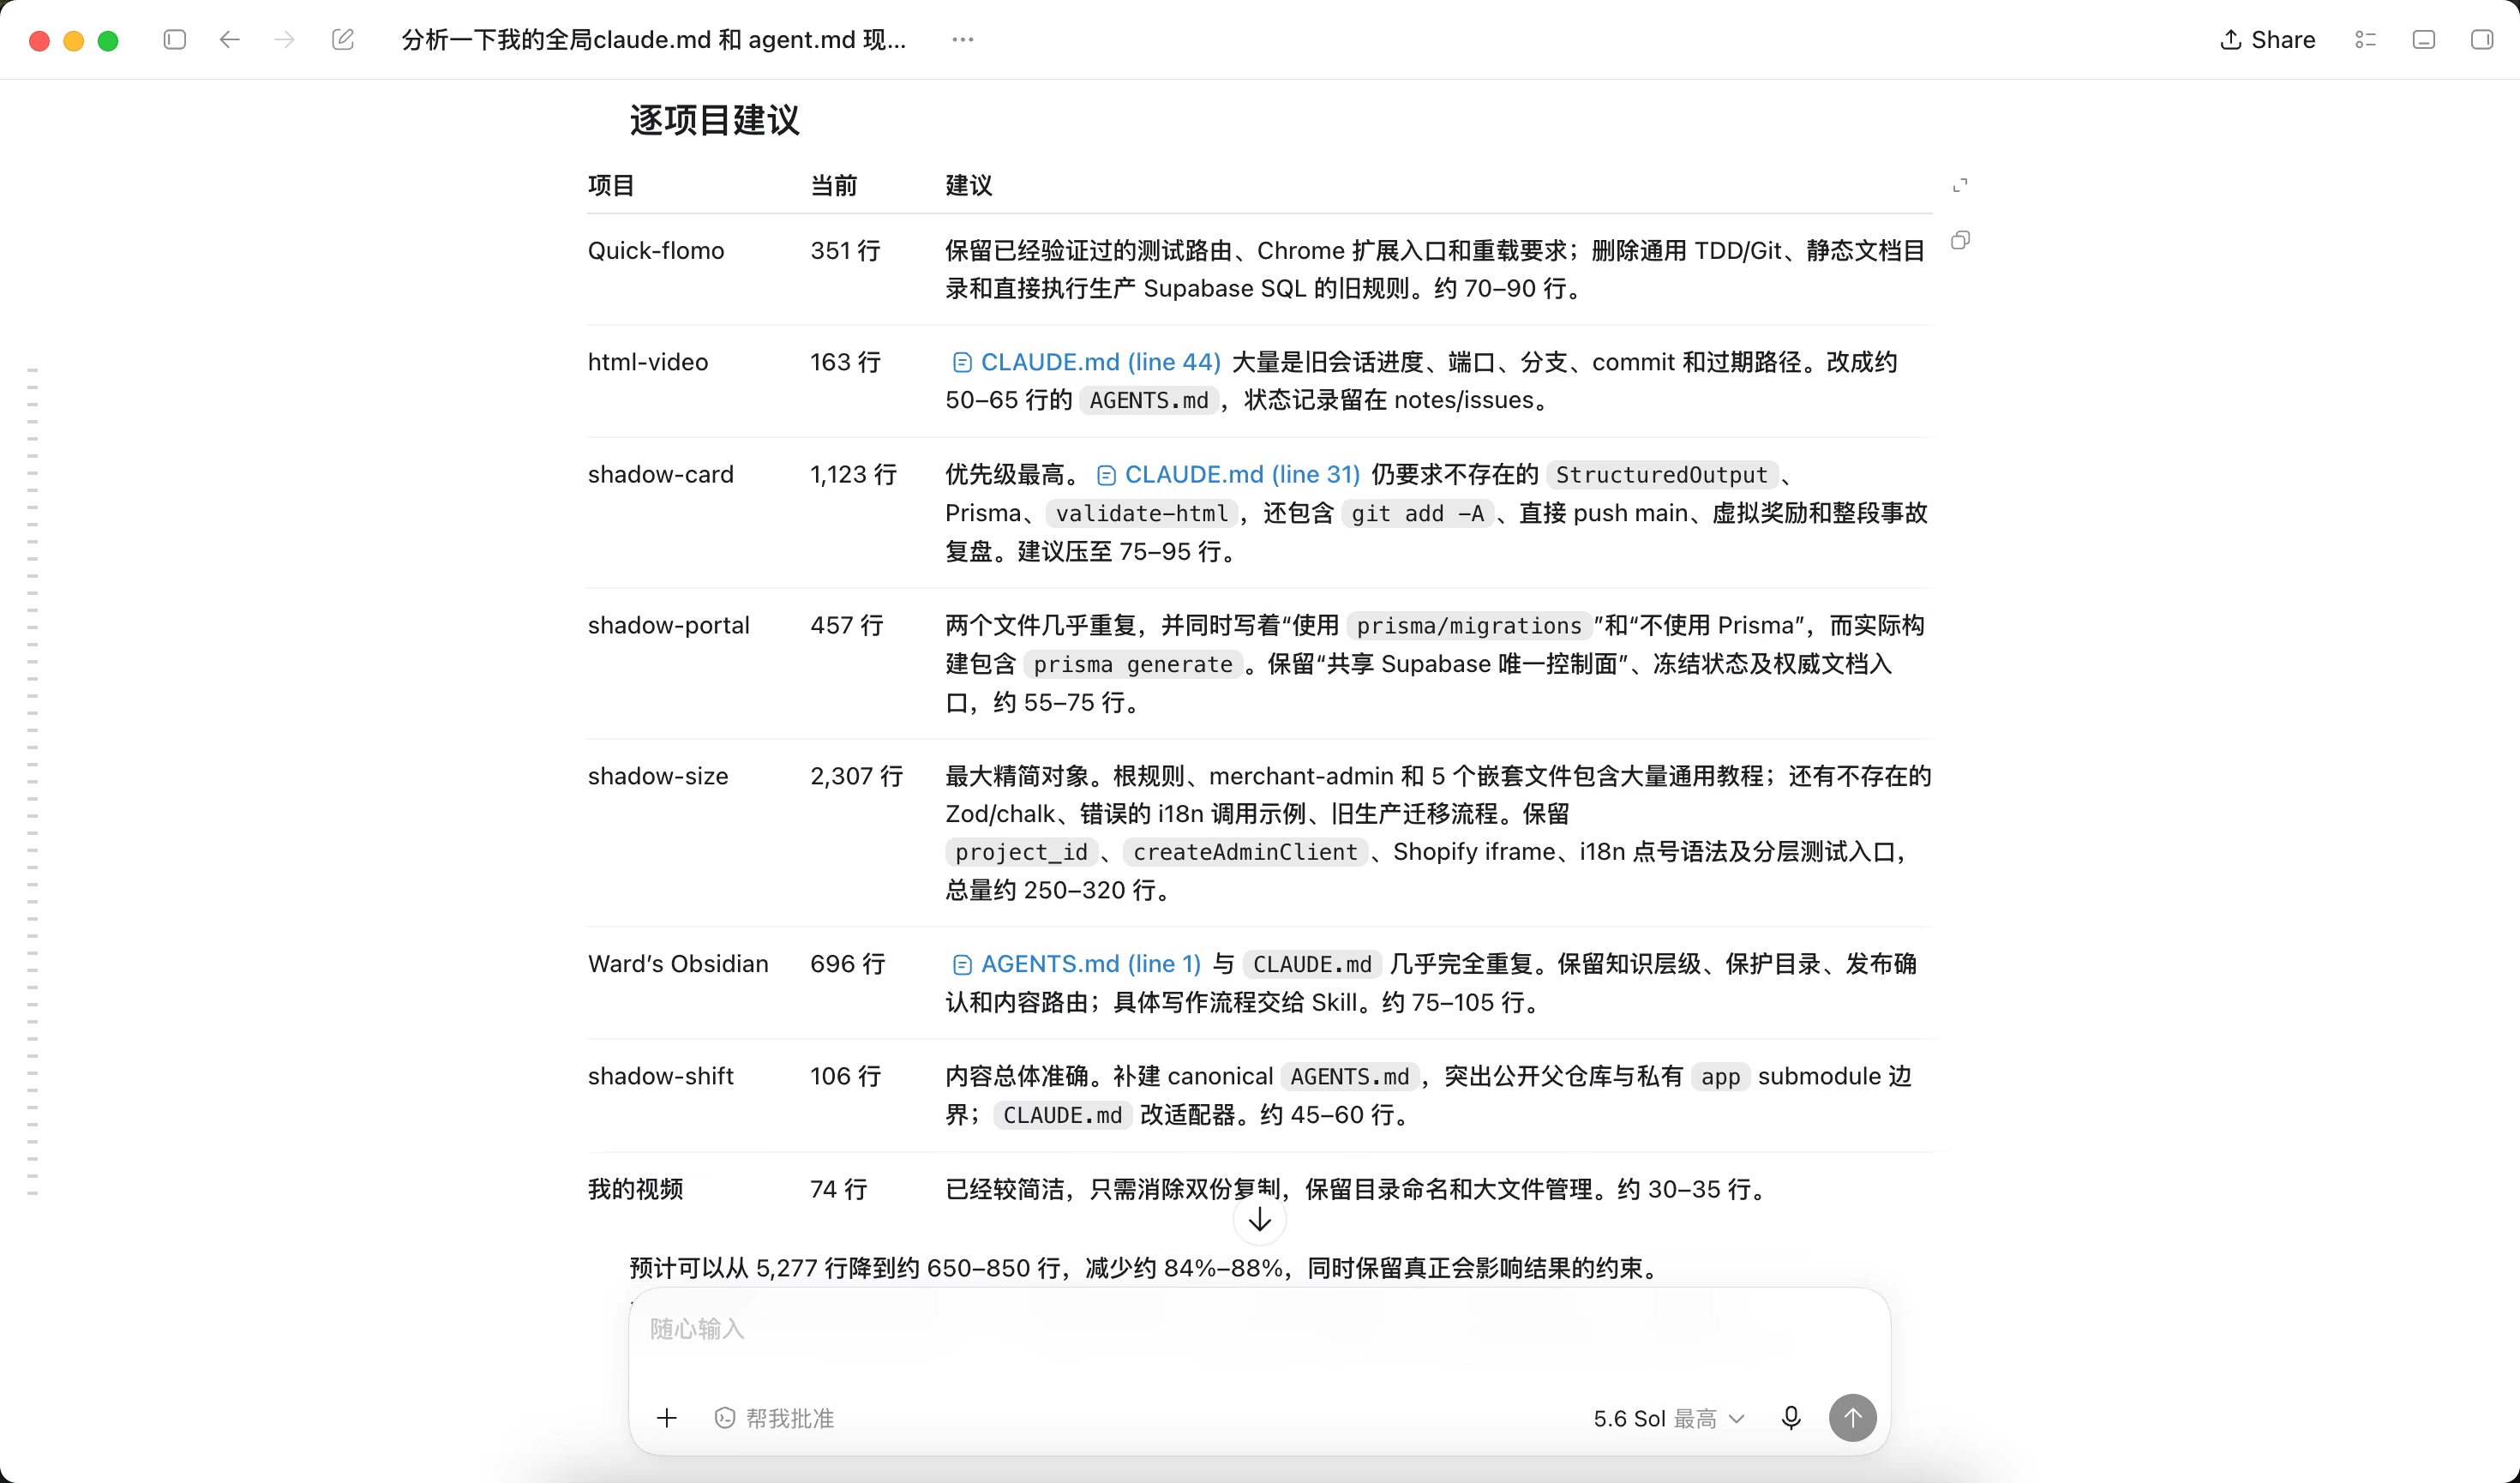
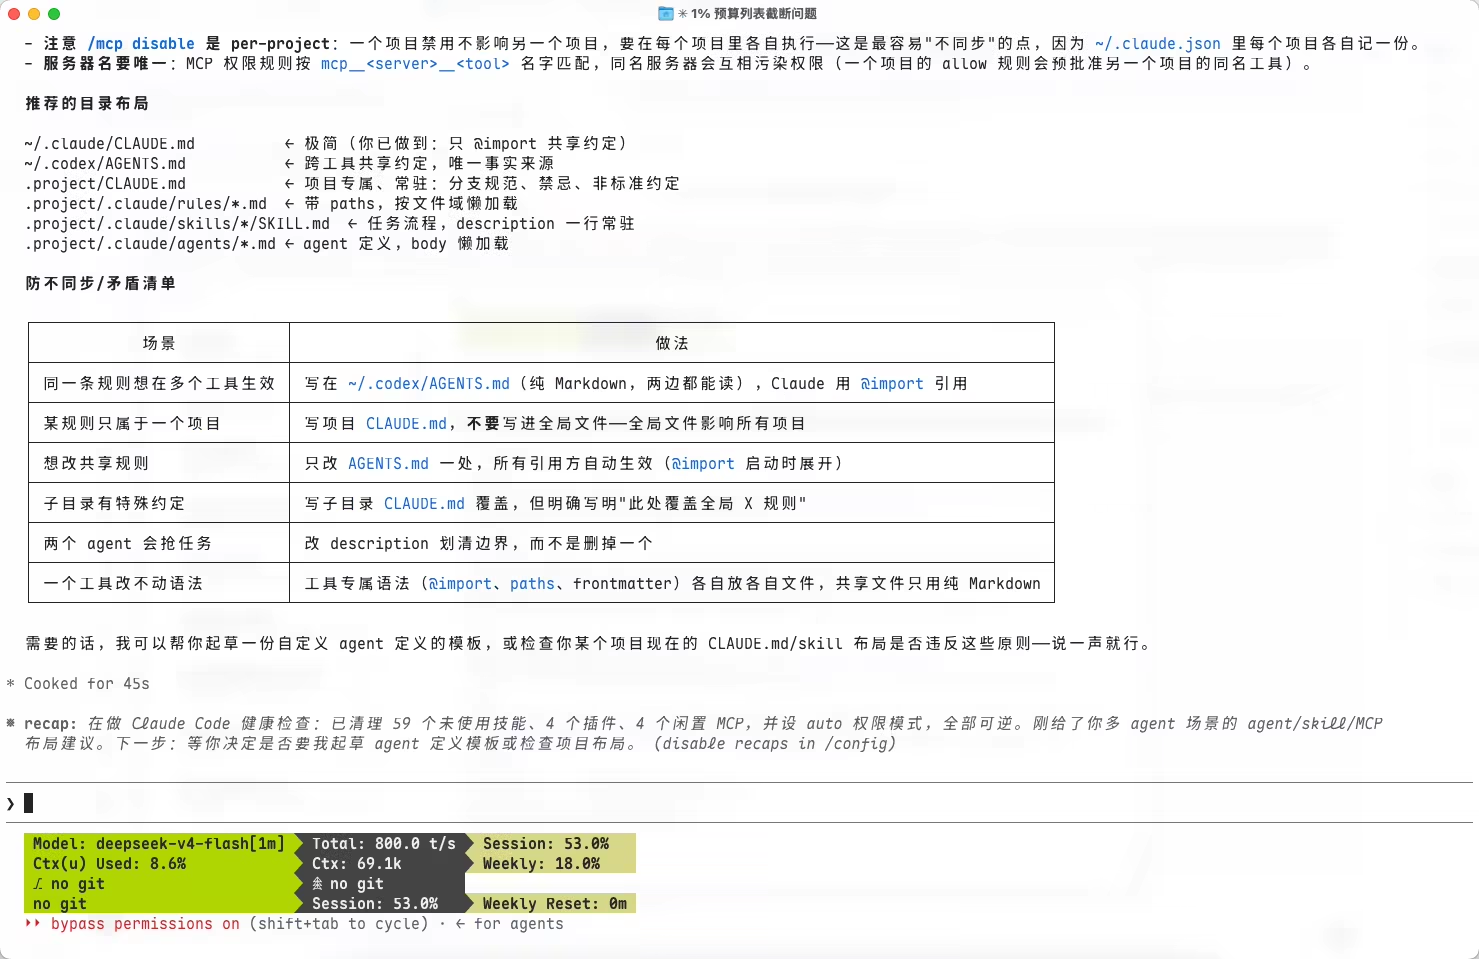
我電腦裡的這幾千行舊規則現在成了負資產。一方面規則太長會擠佔有效上下文,關鍵的專案命令寫在後面經常被直接漏讀;另一方面我平時 Claude Code、Codex 和 Antigravity 換著用,每個工具存一份設定,時間一久各處命令對不上,同一個專案在不同用戶端裡跑出完全不同的行為。
我把所有設定推倒重寫了
想通之後我讓AI把本機設定徹底重構了一遍:
- 全域事實源只保留
~/.codex/AGENTS.md並縮減到 36 行; ~/.claude/CLAUDE.md僅用一行@~/.codex/AGENTS.md引用;- Antigravity 的
~/.gemini/GEMINI.md同步維護一份 37 行左右的版本; - 20 個專案根目錄的規則逐個重寫壓縮,只留專用的 build 和 test 指令。
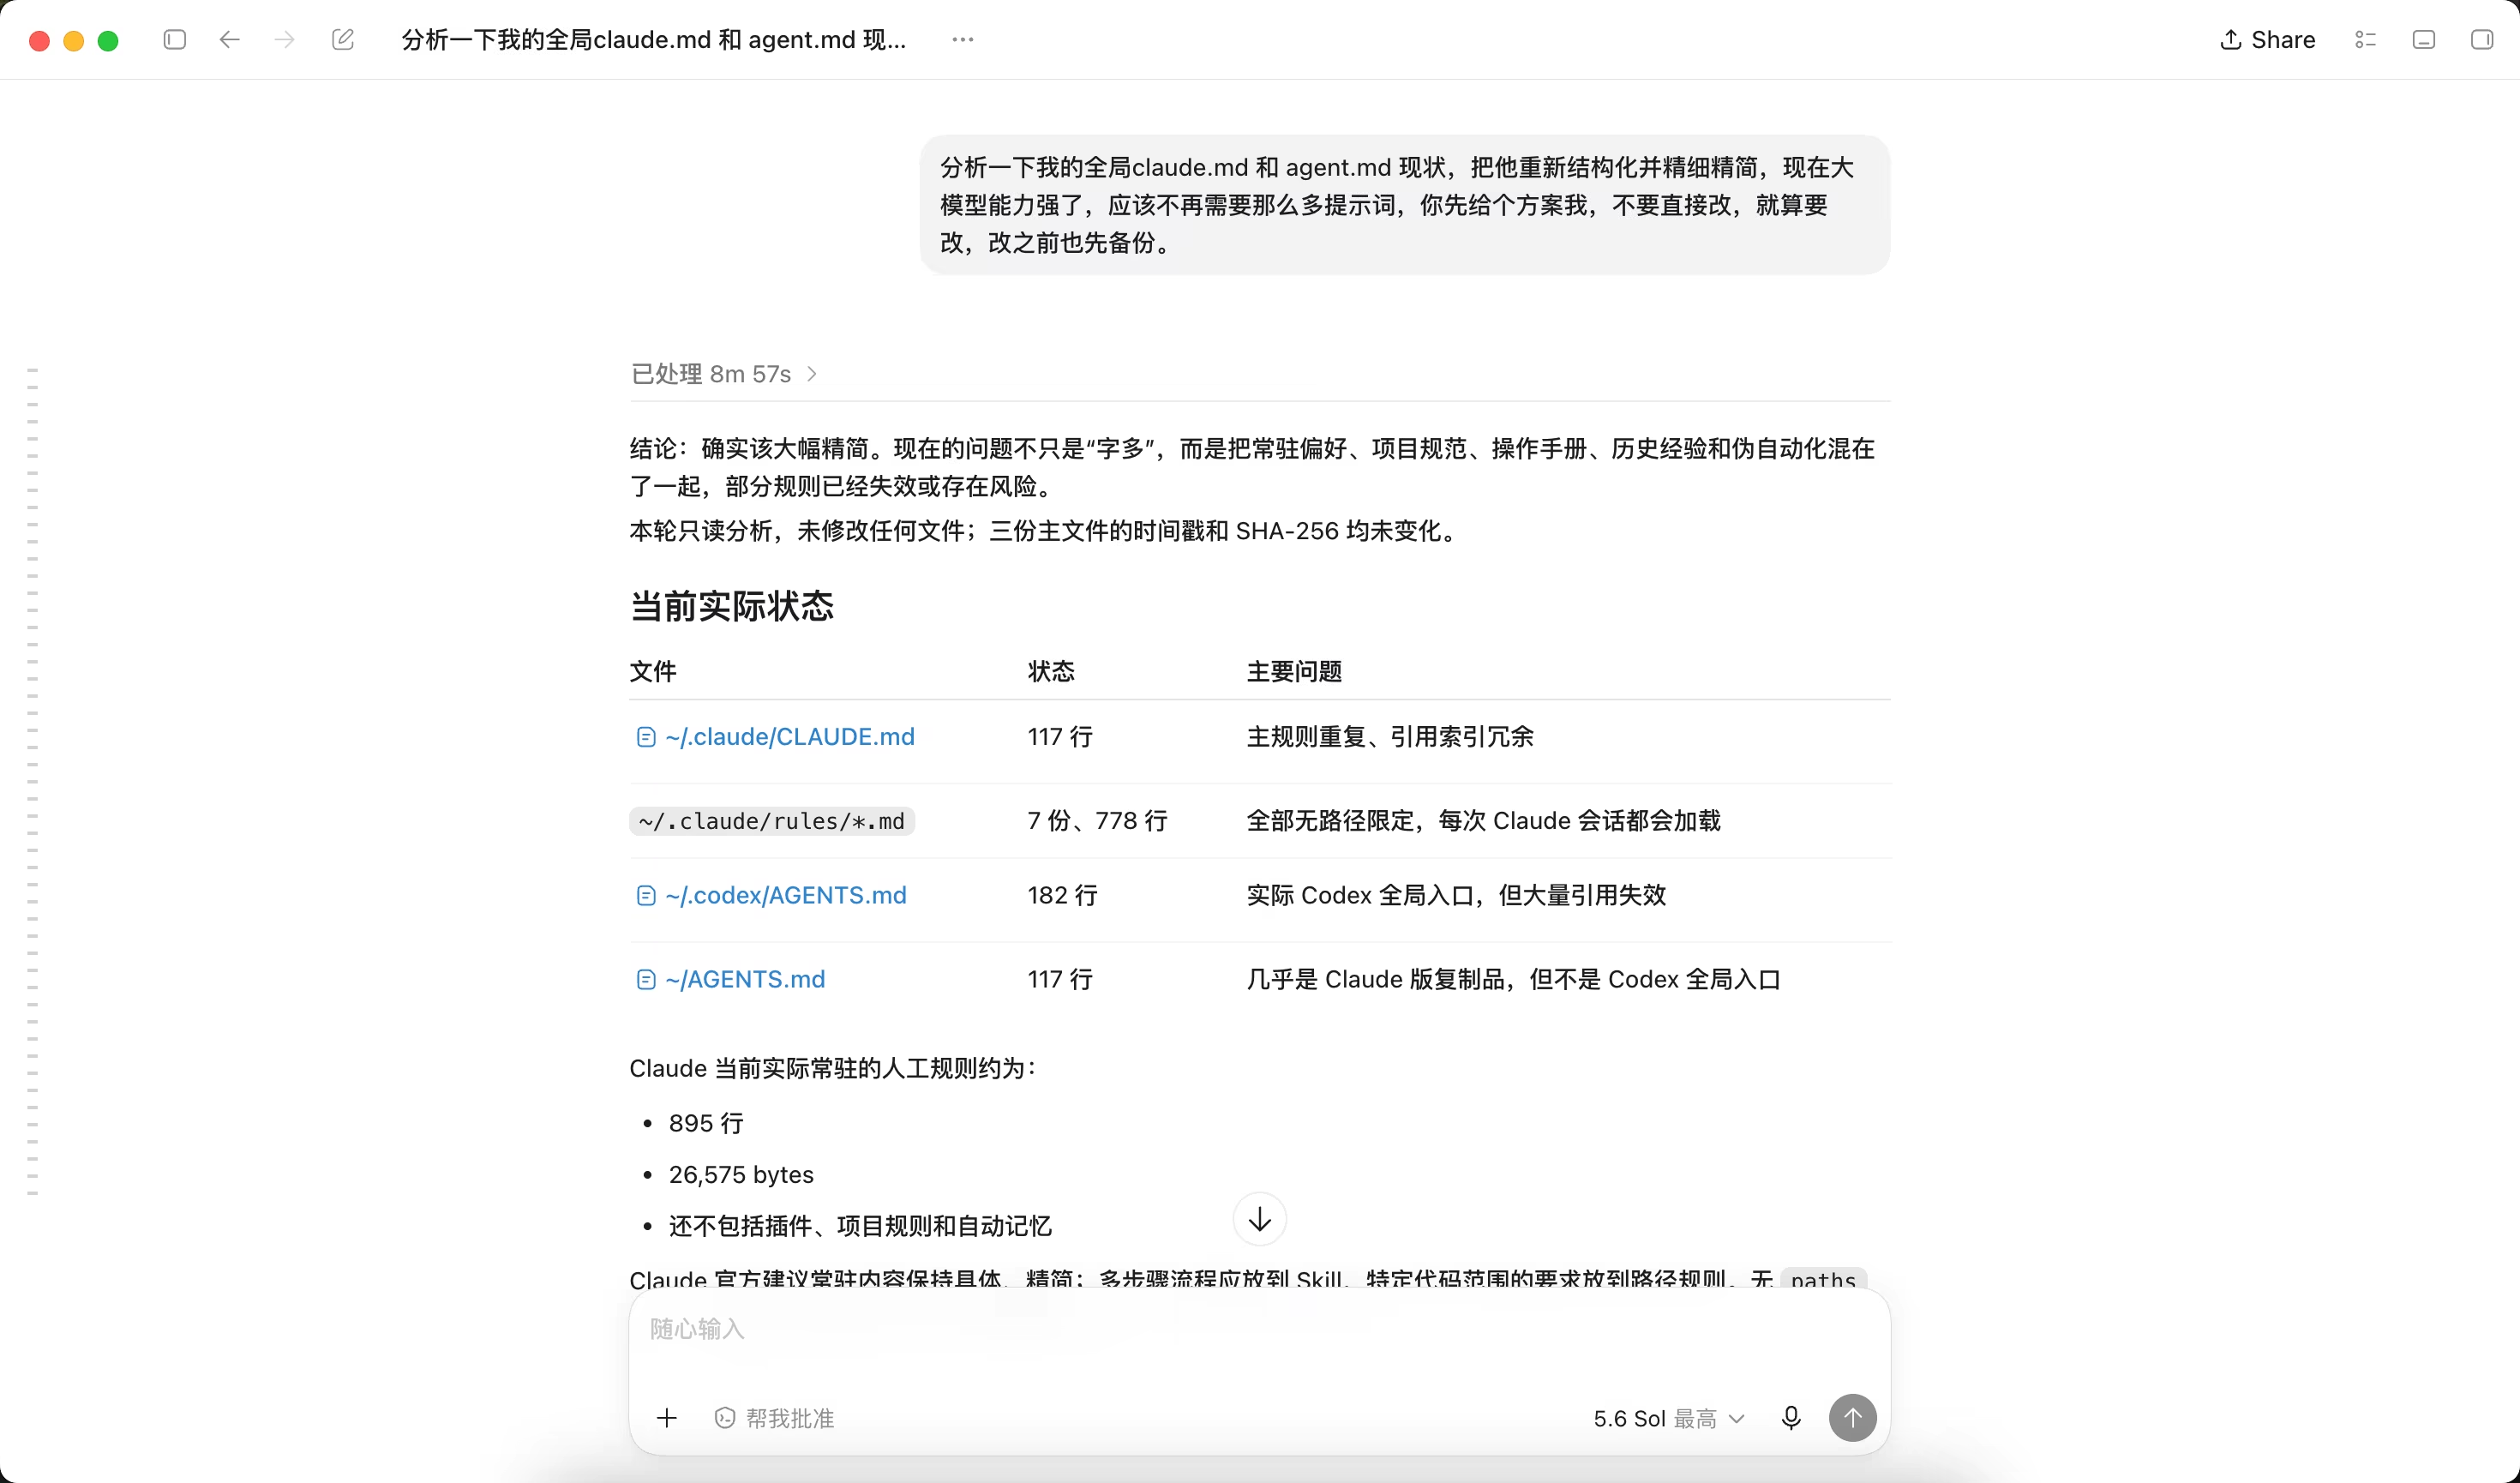
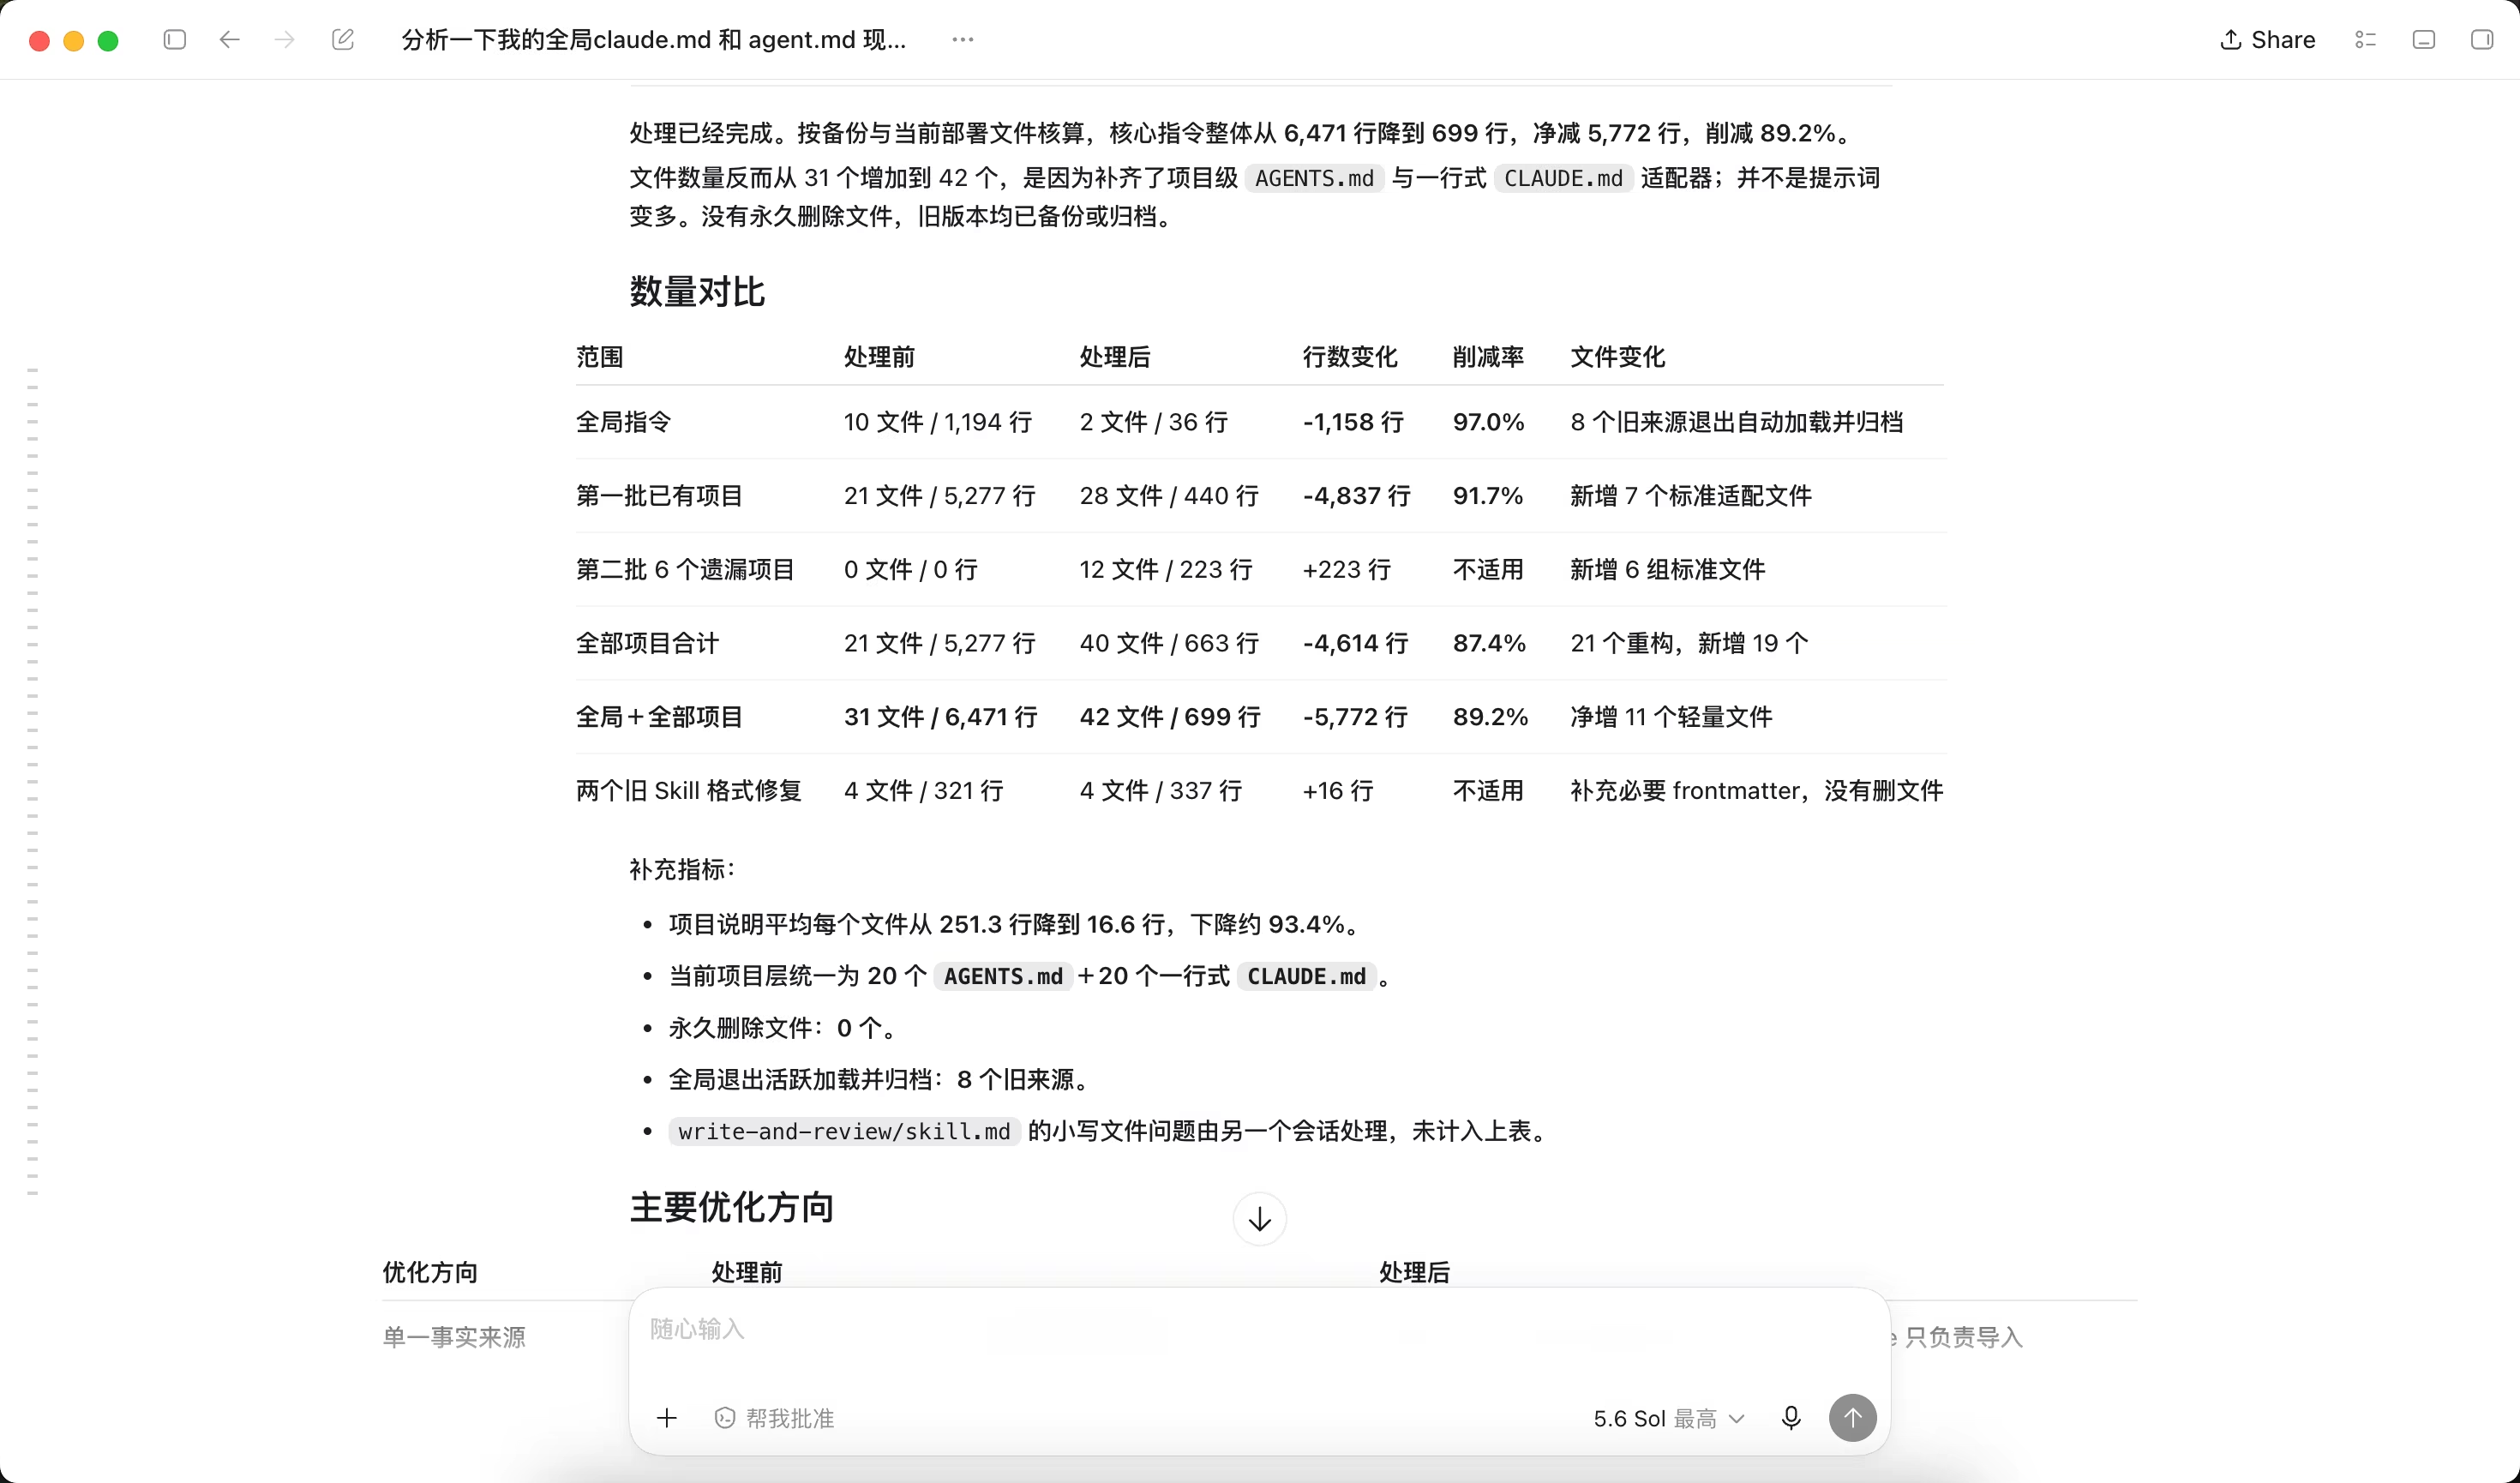
重構前後的資料對比(2026 年 8 月實測):
| 範圍 | 清理前 | 清理後 | 變化 | 降幅 |
|---|---|---|---|---|
| 全域規則 (Codex / Claude) | 10 檔案 / 1,194 行 | 2 檔案 / 36 行 | -1,158 行 | 97.0% |
| 全部專案級規則 (20 個專案) | 21 檔案 / 5,277 行 | 40 檔案 / 663 行 | -4,614 行 | 87.4% |
Antigravity (~/.gemini/GEMINI.md) |
1 檔案 / 123 行 | 1 檔案 / 37 行 | -86 行 | 69.9% |
| 全量總計 | 32 檔案 / 6,594 行 | 43 檔案 / 736 行 | -5,858 行 | 88.8% |
總行數從 6594 降到了 736,降幅 88.8%。在 Antigravity 介面實測(2026 年 8 月),全域規則初始化從幾千 Token 降到了 956 Tokens。
讓 AI 跑的兩段話
我讓AI處理完後讓他將我上面所做的事情整理成了兩段提示詞,你可以拿去用:
给我扫一下本机所有 AI 规则(~/.codex/AGENTS.md、~/.claude/CLAUDE.md、~/.gemini/GEMINI.md 和各个项目目录下的配置),只读分析,千万别改文件。把里面的废话、通用教程和过时命令揪出来,全局统一收敛到 AGENTS.md(CLAUDE.md 单行引用),各个项目只留专用的跑测与构建命令,压缩到 30 行内。先给我看行数统计和精简方案。
等它列出方案確認無誤後,再回它一句動工:
就按这个方案改。修改前务必先完整备份到 ~/.agent-instructions-backups/ 带时间戳的目录并生成 SHA256 校验,写完后把前后的行数对比打给我。
改完這套設定跑了幾天,最直觀的體會是它手腳乾淨多了,不再借著改小需求到處動無關程式碼,切不同工具也不用反覆折騰環境。
只用Claude Code 更推薦你使用這個指令
準備發這篇文章前才發現 Claude Code 自己已經有類似的功能了。Claude Code 的作者 Boris Cherny 在 2026 年 7 月 9 日的推文裡介紹了這個新功能。
只需要執行簡單的checkup指令,也就是之前的 /doctor。在我當時使用的 2.1.237 版本里,兩者是同一個命令。不過這個指令只能處理Claude Code的設定,其他Agent不適用。
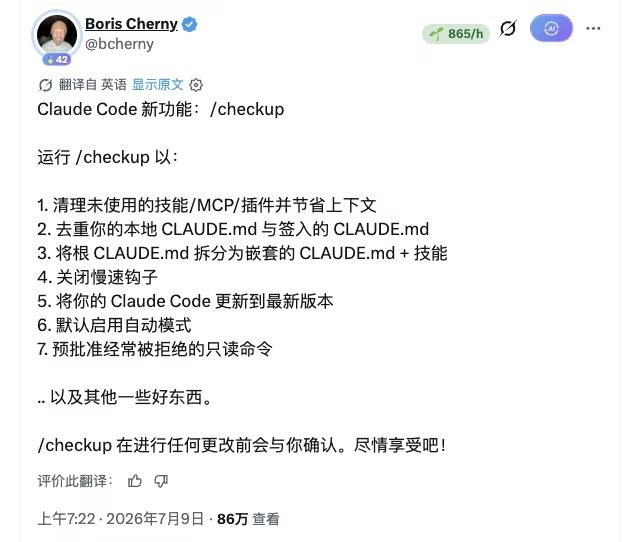
/checkup
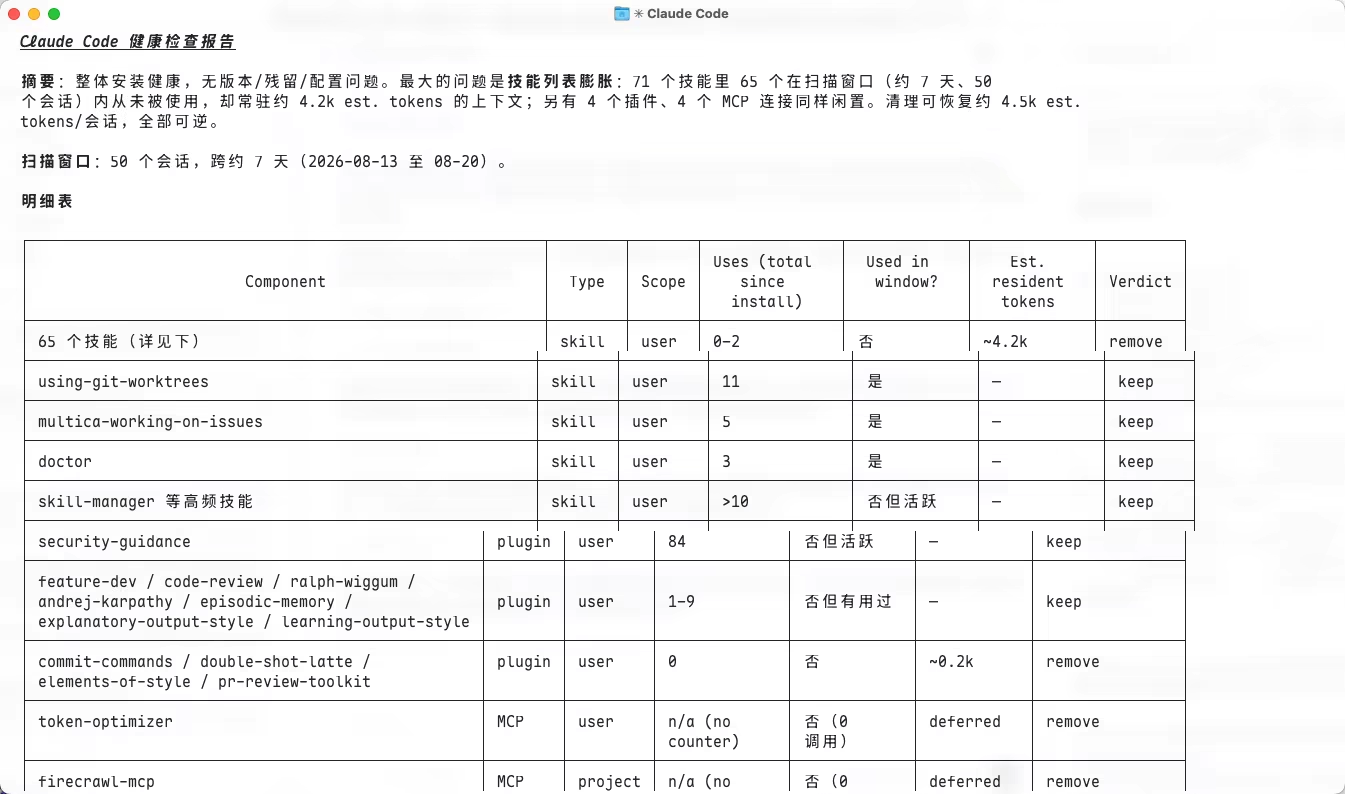
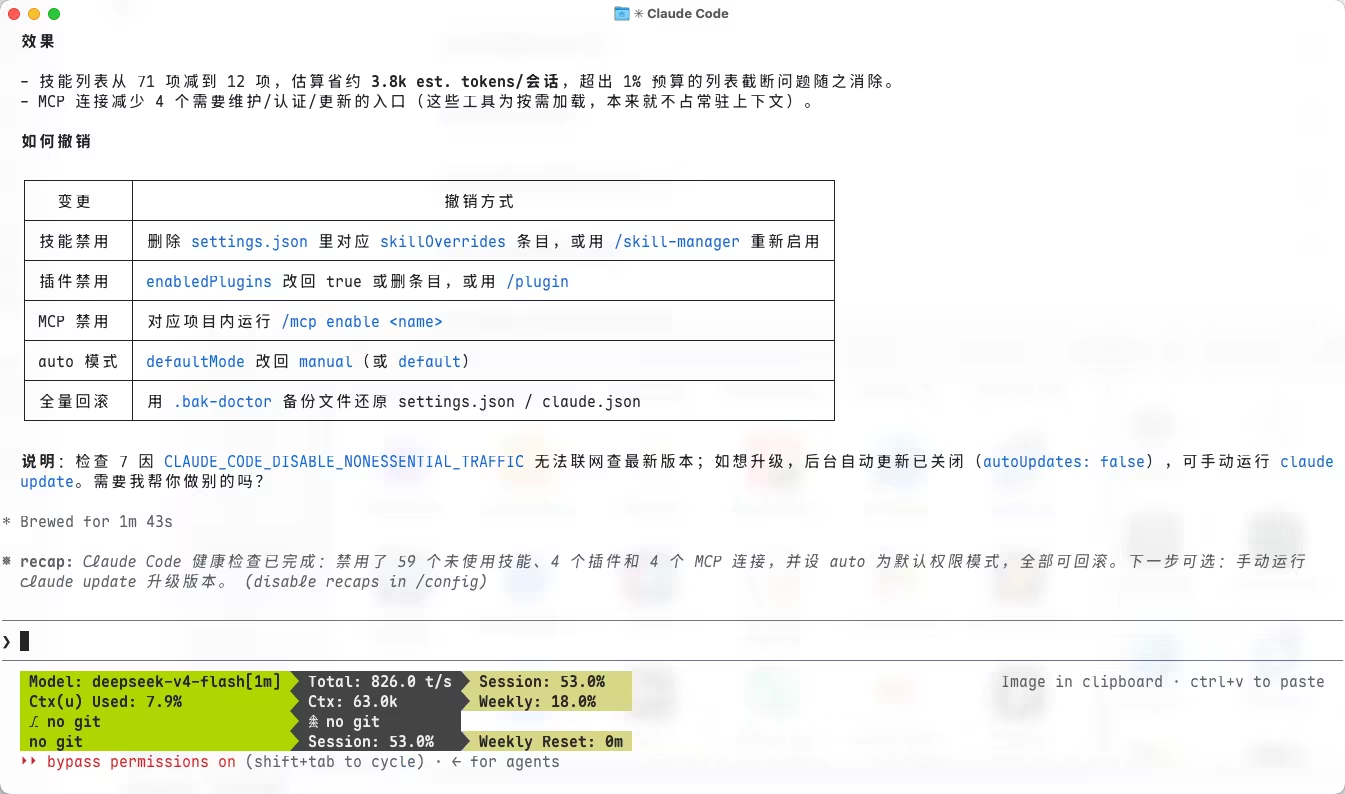
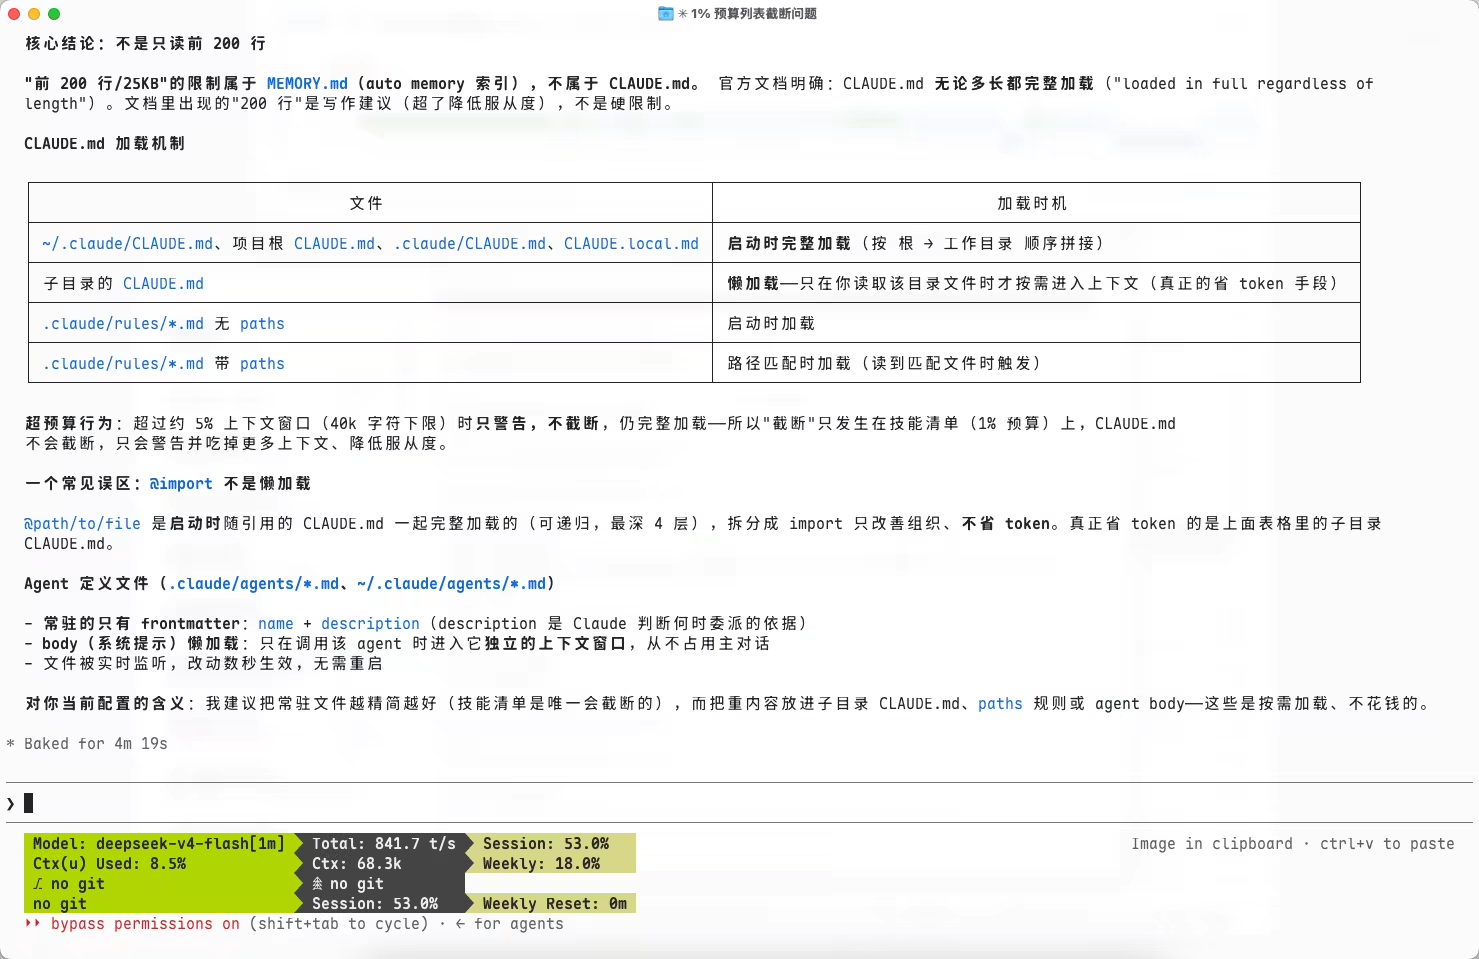
這個指令除了claude.md,skill、MCP、外掛都會一併清理。而skill、mcp其實我在執行這個指令前也已經處理過一輪,這次執行這個命令再次做了修補,效果還可以。這次的範圍是:停用 59 個未使用技能(其中 53 個從未使用,6 個低頻)、4 個外掛和 4 個閒置的 MCP 連線,技能列表從 71 項減到 12 項。報告初版寫的是 65 個未使用技能,核對腳本後更正為 59 個。可以看看下面的圖片。
上下文載入機制
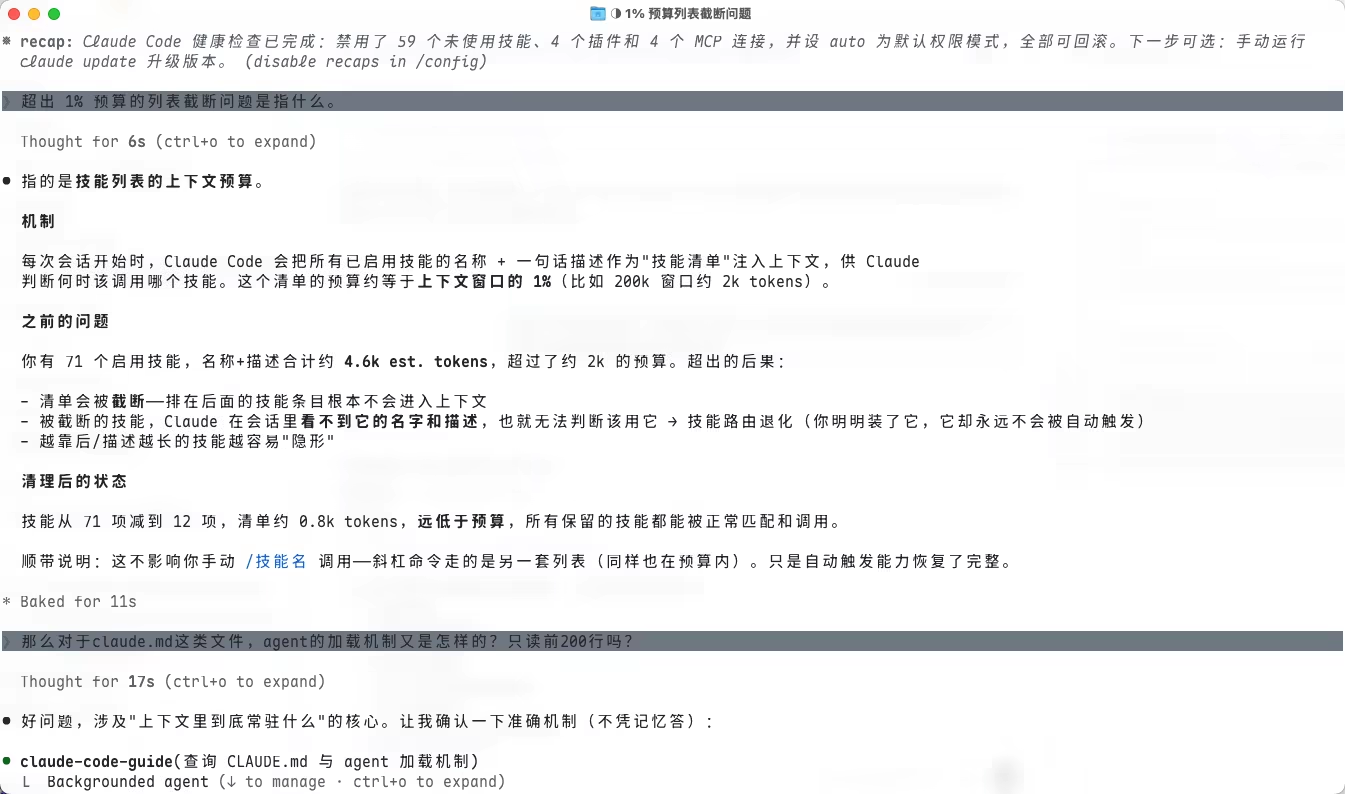
在這次執行doctor指令期間,Claude Code還解答了兩個我之前對於上下文載入的疑問:
- skill列表的上下文載入預算是多少?
答:約等於上下文視窗的 1%(依據 Claude Code 官方 Skills 文件),200K 視窗約為 2K tokens。它說我當時 71 個啟用技能合計約 4.6K tokens,超過了 2K 的預算,怪不得我之前使用一下模型會發現斜槓命令搜不到一些skills,原因竟然是在這裡。不過現在不少模型已經是百萬上下文視窗,按同樣的 1% 比例,預算約為 10K tokens。不過沒必要載入就不載入,畢竟浪費token也影響效能不是。
- Claude.md 的載入邏輯是怎樣的?
答:我之前看到有人說只加載前200行,原來不是的,說的是memory.md。而Claude.md會完整載入,200行只是寫作建議,太長會降低服從度。
關於 CLAUDE.md 和 AGENTS.md 這類 Agent 定義文件的清理就說到這裡。
下一篇講的是我怎麼梳理 MCP 和 Skills:拔掉常駐的 MCP,清理被底座內化的 Skill,並用 CC-SWITCH 統一管理。
如果需要,我也接 1v1 諮詢,以及 Skill 和工作流定製。