目錄
9 月 5 日到 6 日,我把 GPT-6 當作預設模型連續重度使用了兩天。
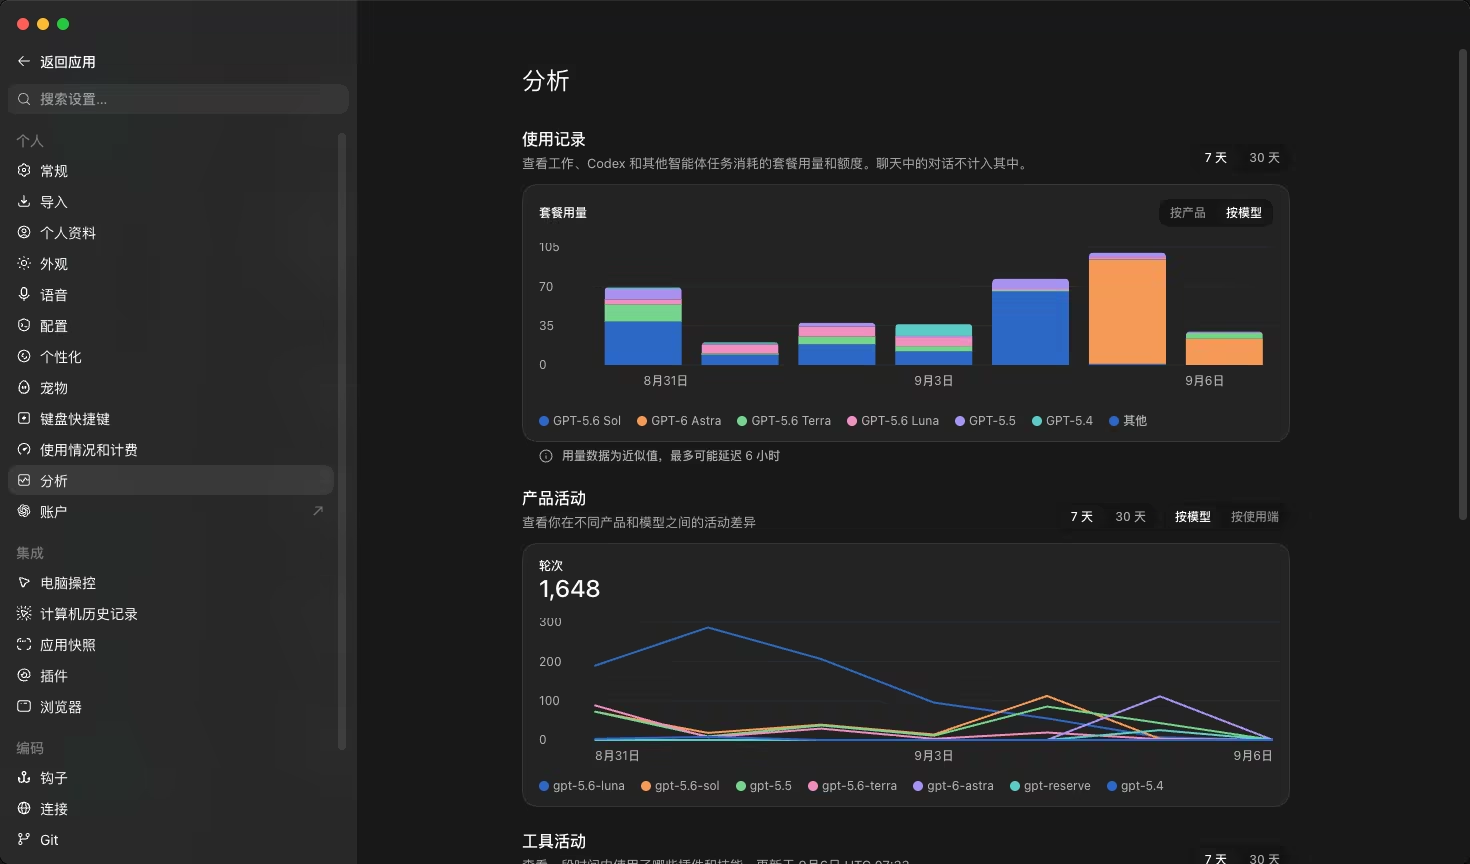
按我的真實使用記錄,前後消耗了接近兩張重置卡對應的額度,用的還是 5x 檔。速度變快的體感確實非常強烈,但在我這些日常工程任務裡,成品品質和解決問題的能力,暫時沒有感到同樣明顯的代際提升。
這兩天社交網路上幾乎到處都在吹 GPT-6 / Astra 的 3D 空間理解有多強、全模態交付有多逆天。
我也第一時間拿它實測了一個非常具體的任務:為我自己的個人 IP 形象,從 0 到 1 做一套可互動執行的 3D 資產與工程程式碼(GLB 網格、構建原始碼與示例工程)。
第一步先讓它出概念設計。Astra 自己構思並生成出來的 3D 概念圖,效果不錯——多角度三視圖、面部微表情、髮絲光影,甚至連分層材質拓撲和 .blend 格式支援都標得有模有樣,直接拉滿了皮克斯動畫大片的質感:
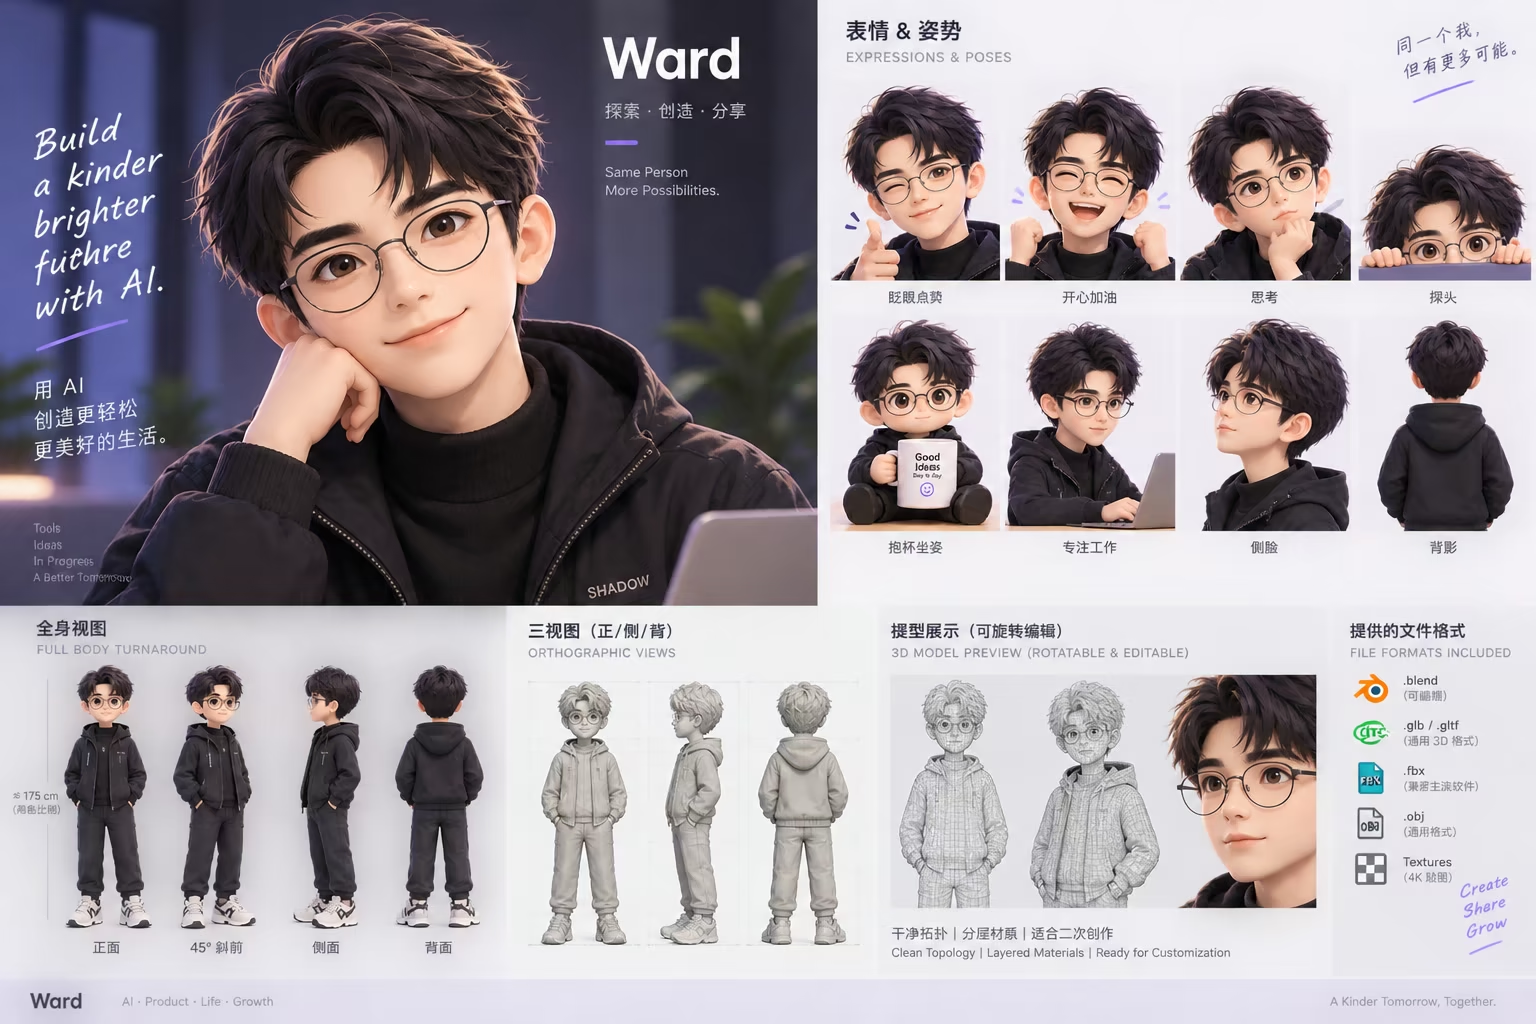 ▲ Astra 自己生成的 3D 概念效果圖:三視圖、微表情、髮絲光影一應俱全,把期待值直接拉滿
我心想這未免也太強了,於是緊接著讓它進入工程落地環節:「好,現在把這套設計真正用程式碼跑起來,交付可互動的 3D 模型與 GLB 檔案。」
結果,Astra 一通程式碼猛如虎,真正編譯交付出來的 3D 工程原型,直接長成了這樣:
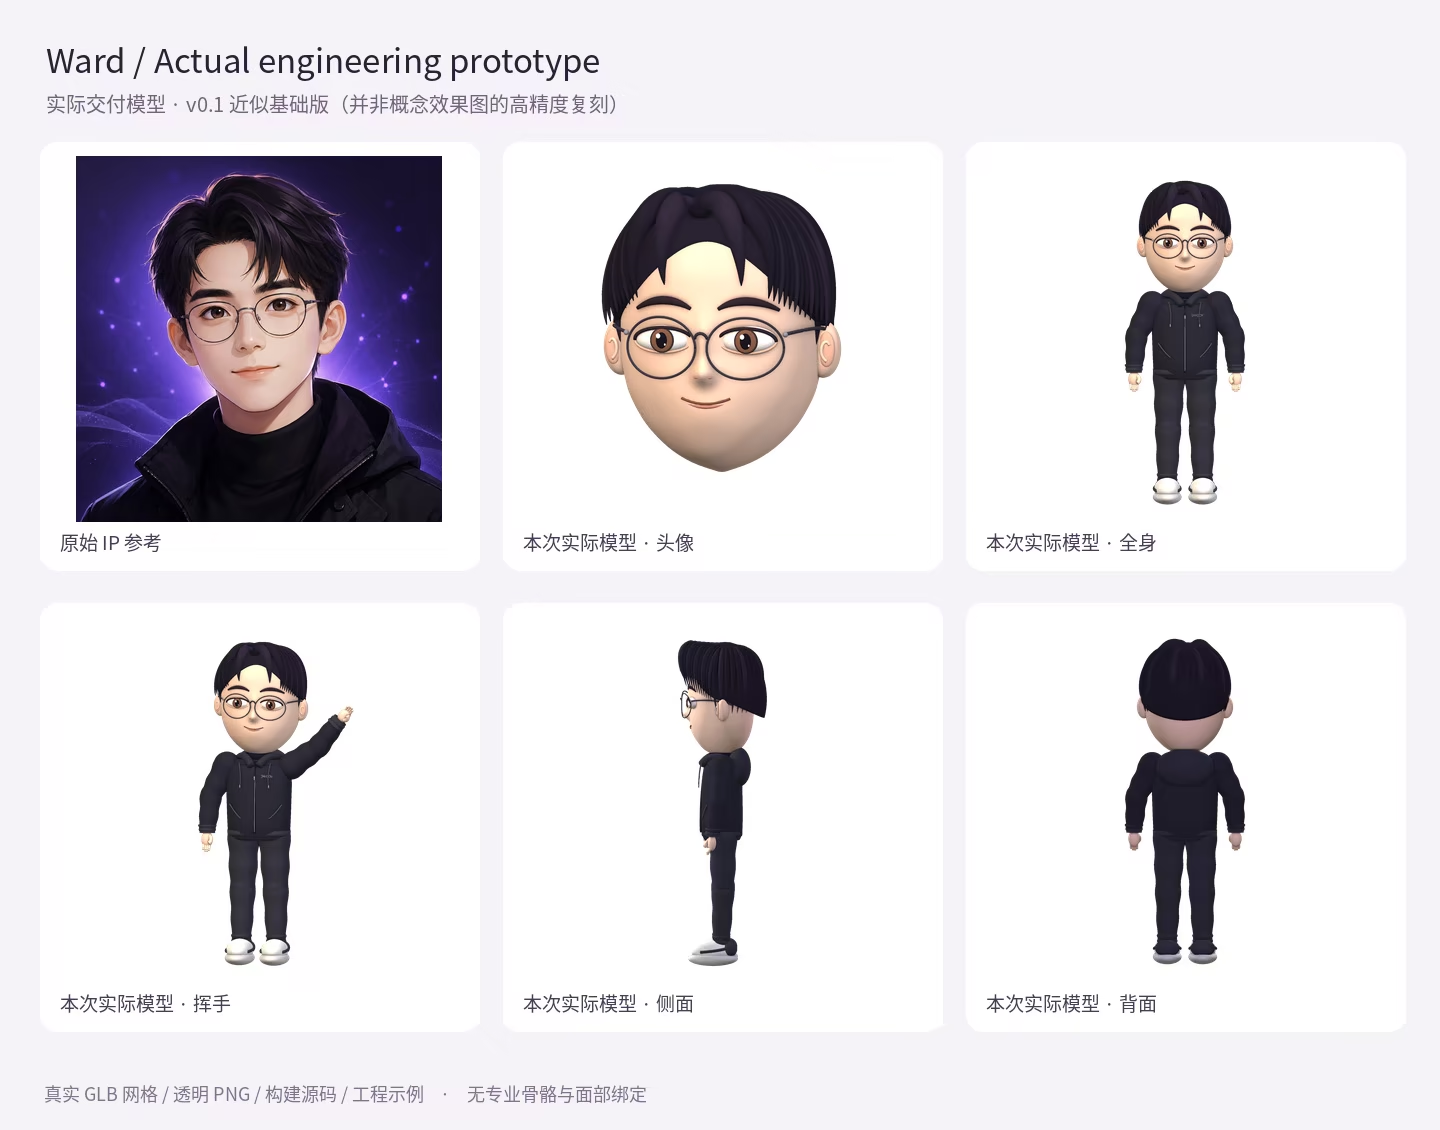 ▲ Astra 自己寫程式碼交付的實際工程模型:直接捏出了一個呆萌的低多邊形小人,甚至老老實實打上了免責小括號——「並非概念效果圖的高精度復刻」 🤣
看到成品我樂了:在概念設計階段,它的構思與審美確實驚豔;但真到了從零用程式碼解空間幾何、建網格的工程落地環節,它交付的依然只是一個基礎的拓撲原型。
最有趣的是連它自己都有清晰的邊界認知,在交付板裡誠實地註明了:「並非概念效果圖的高精度復刻」。
我舉這個真實的例子,絕不是要苛責 GPT-6——坦白講,能純靠程式碼與自然語言從零搓出一套可互動的 3D 網格和示例工程,本身就已經是非常了不起的突破。
我只是想借這個反差提醒大家:GPT-6 很強,只是不應該被神化。
儘管在 9 月 3 日發布當天的媒體吹風會上,OpenAI 聯合創始人兼總裁 Greg Brockman 被問到 Astra 是否算 AGI 時說:「For me personally, I do think we're there」(我個人認為我們已經到了),吹風會結束時又說了一句「Welcome to the AGI era」(據 VentureBeat 2026 年 9 月 3 日報道),全網科技媒體也紛紛打出「歡迎進入 AGI 時代」的頭條;但回到當下的工程一線,這個可愛的低模小人依然提醒著我們:現實距離那個理想中的 AGI,還是有一段距離的。
當然,現在大模型的能力還在高速發展中,技術演進一日千里,說不定再過幾個月、下一次迭代升級時就真的到來了。但至少在眼下的日常開發裡,它依然是一個需要人類明確邊界、嚴謹分工的強大工程輔助工具,而不是隨手一指就能包辦一切精細落地的全能魔法。
如果你也在 Codex 桌面端裡用它寫程式碼,開工前我建議先放下那些「一鍵成神」的過高預期,先做一件極具針對性的事:讓它自己審視你的本機環境,把阻礙提效的冗餘規則砍掉。
文章後半部分包含兩組同題對照實驗的資料,以及一張不同任務的模型與思考強度建議表,均來自真實會話記錄與本機測試(單次實測,n=1),供你客觀參考。
一、 開工第一步:別用它做加法,用它做減法
很多人用上新模型的第一本能,是「給它多加點活」——寫更長的人物設定、追加更多檢查項、恨不得把思考強度無腦拉到滿血。
但兩天折騰下來,我最深的一點體會恰恰相反:面對更聰明的新模型,最好的駕馭方式是讓它幫工作流「做減法」,而不是做加法。
你在實際協作中真正應該衡量的,是少了多少返工、遺漏和錯誤決策,而不是回答長了多少、想了多久、多跑了多少輪多餘測試。 如果一個模型更聰明,它的首要價值應該是幫我們收斂範圍、砍掉偽需求、直奔交付物,而不是順手把系統設計搞得過度複雜。
這也是為什麼在正式開工前,我沒有直接讓它寫大段程式碼,而是先在 Codex 桌面端開了一個新會話,把下面這段專門整理的「自我診斷提示詞」發給了它。
讓它先根據本機可存取的歷史任務和使用記錄,客觀歸納我們在做什麼,並找出導致卡頓和過度測試的規則根源。
可直接複製的 Codex 自診斷提示詞
使用提示:在 Codex 桌面端直接開新對話傳送,不需要自己先手動總結場景。普通網頁版 ChatGPT 無法讀取本機設定與 Codex 會話記錄。
请先分析我真实使用 Codex 的方式,不要让我先填写场景:

1. 阅读当前对话和可访问的历史 Codex 任务,按任务类型归纳我实际做过的工作,例如编码、排错、配置、写作、研究、浏览器或文档处理。只引用能核实的任务,不编造案例。
2. 如果本地有会话遥测或 Codex Doctor,优先使用只读、隐私安全的分析模式,观察任务时长、重复尝试、验证范围、模型/思考档位和额度相关记录。没有权限或数据不足时明确说明,不用猜测补齐。
3. 从 3 到 5 个有代表性的近期任务中找出模式:哪些工作完成得顺利,哪些出现返工、停顿、过度测试或额度消耗快。只报告必要的任务摘要,不输出原始会话全文、密钥、Token、Cookie、个人资料或无关路径。

结合这些实际证据和当前官方 OpenAI 文档,再只读审阅实际生效且与我的使用有关的 AGENTS.md、项目规则、Skills、config.toml、MCP、plugins 和 profiles。无法读取的内容直接标为未验证,不要猜测。

先保护隐私:不要读取、复制或输出密钥、Token、Cookie、个人资料和无关项目内容。搜索配置时只报告文件路径、字段名和是否存在,不展示值。不要扫描无关目录,不联网安装依赖,不修改文件,也不运行额外模型对照测试。

请重点回答:

- 我现在主要有哪些使用场景,各自适合什么模型和思考强度?
- 哪些建议是由我的会话证据支持的,哪些只是个人参考?
- 哪些规则会导致反复确认、返工、测试过多、回复过长或额度消耗快?给出文件路径、行号和原条款。
- 是否值得调整默认模型、subagent、并发、上下文、网络、MCP、插件或 Skill?优先给出可逆方案。

请先用这张表交付结果:

| 场景 | 会话证据 | 当前问题 | 建议模型/思考强度 | 升级条件 | 信心 |
| --- | --- | --- | --- | --- | --- |

表格之后给出最多三项最小调整方案。每项说明改哪些文件、为什么、怎样验证、怎样恢复。分清官方事实、我的会话证据和个人建议;没有对照验证的模型推荐,不要写成通用结论。

先只读交付分析和方案。我确认后再修改。修改前先备份,保留无关改动;修改后用实际消费配置的命令验证。不要提交 Git、发布、部署、修改生产数据或自动切换默认模型。
跑完這段提示詞,你應該能拿到一張附帶精準檔案路徑和條款出處的調整清單。如果它只泛泛地說「建議精簡提示詞」,卻指不出具體哪一行規則在添亂,就要求它繼續定位,直到看清楚改動目標再動手。
順便提一句,提示詞裡提到的 Codex Doctor 是我自己寫的一個輕量 Skill。它會只讀分析本機 Codex 會話遙測,統計任務耗時、Token、工具探索、失敗命令和驗證次數,幫助識別上下文膨脹、探索不收斂和過度驗證等訊號。它純本機執行,不調模型也不耗額度。
如果你也用 Codex,可以用下面這條命令安裝:
npx skills add WardLu/skills --skill codex-doctor --global --agent codex --yes
二、 官方提醒,應該怎樣落到本機設定?
重讀 OpenAI 針對 GPT-6 Astra 發布的開發者文件(2026 年 9 月),你會發現官方其實非常坦白地指出了新模型的幾個固有行為傾向。它們恰好解釋了大家這兩天常遇到的不順手:
- 更愛澄清求證:官方說它在「額外輸入可能明顯改變結果」時更可能向使用者提問,遇到輕微模糊也更容易停下來,導致卡在使用者希望它繼續的地方;
- 對規則檔案極度敏感:官方寫明它對
AGENTS.md和 Skills 等檔案裡的指令更敏感,規則之間一旦有不清楚或相互衝突的地方,可能提前停下、阻塞工作; - 容易過度測試:官方提到它對編碼任務的測試很徹底,小任務上可能跑得比任務本身需要的更寬;
- 語言習慣偏掃描式:官方稱它傾向用列表、表格和 Markdown 讓回答便於掃讀,我的體感是它也容易生成冗長的大綱。
針對這幾項官方公開特性,我在本機規則中做了如下對應調整:
| 遇到的現實痛點 | 官方原理解析 | 我的本機落地規則與寫法 |
|---|---|---|
| 已經說了「幫我改」,還頻繁停下問能否繼續 | 模型協作意願增強,遇到微小不確定性偏向停頓求證 | 顯式授權已有要求持續有效;約定「低風險可逆細節自行判斷,終審交付再問我」;暫停時必須給出具體規則出處 |
| 改一行文案也寫完整頭腦風暴計畫 | 模型執行意圖過於徹底,容易被通用設計 Skill 誤觸發 | 給頭腦風暴 Skill 增加觸發門檻,為清晰明確的小任務保留直接執行通道 |
| 測試越跑越多,遲遲不交付 | 模型在工程任務中過於追求徹底(Thorough) | 顯式約定「相稱性檢查」:僅執行與改動風險相符的驗證,驗收通過即停止,不因假設擴大測試 |
| 回答太長、排版格式氾濫 | 預設傾向掃描式條目與固定過渡套話 | 明確要求「先結論、後關鍵證據」,省略無意義的開頭與重複總結 |
| 多 Agent 併發容易雪崩 | 並行排程時缺乏顯式約束與預算邊界 | 明確指明子代理適用任務與併發預算,先判斷工作能否獨立拆分 |
在具體環境裡,我把需求階段的 brainstorming 保留為顯式呼叫(需要時手動叫它,小修改不自動觸發);把寫死的 100 萬全局上下文和 90 萬壓縮閾值移回可選設定;並停用了幾項低頻的 MCP。
這也正好接上了我 8 月寫的兩篇覆盤:上篇《AI 降智秒解(上):先給規則檔案瘦身》重點處理了規則臃腫,把本機規則從 6,594 行壓縮到 736 行;下篇《AI 降智秒解(下):清理常駐 MCP 和過時的 Skill》系統梳理了 Skills 衝突與 MCP 氾濫。
那兩篇解決的核心問題是「把本機環境收拾乾淨」。而面對今天對規則更敏感、執行更徹底的 Astra,這套治理不僅沒過時,反而更關鍵了——越聽話的模型,越容不得規則庫裡有半點打架。這一次我多走了一步,結合會話遙測和同題實驗,去客觀檢驗這些瘦身動作到底能不能換來真金白銀的提效。
最後,我在 ~/.codex/config.toml 裡將桌面端新任務的主預設模型與子代理設定做了清晰分層。這裡的 Sol、Luna 屬於 GPT-5.6 系列,與 GPT-6 Astra 是分開的模型,在用量統計裡也是分開列的:
# 主任务默认配置:负责用户直接发起的会话
model = "gpt-5.6-sol"
model_reasoning_effort = "medium"

# 子代理(Subagent)默认配置:负责被主任务派出去的辅助并行工作
[agents]
default_subagent_model = "gpt-5.6-luna"
default_subagent_reasoning_effort = "max"
max_concurrent_threads_per_session = 3
設定背後的權衡:
主任務用 Sol/Medium,保證日常開發快速、穩定、不囉嗦;分派出去的 Subagent 用 Luna/Max 併發限 3,利用 Luna 極低的 Token 單價配合充足的 Max 推理,既解決具體輔助問題,又避免多代理同時鋪開導致周額度瞬間蒸發。
三、 規則瘦身後,究竟有沒有省下成本?
為了避免「自我感覺良好」,我讓 Codex 在獨立環境裡設計了一組基準測試:讓同一個 Astra/Low 在調整前(臃腫舊規則)與調整後(瘦身新規則)的環境下,分別完成一次完全相同的 Python 匯出功能。這組資料是 2026 年 9 月的單次實測(n=1)。
測試程式碼與任務完全一致,獨立驗收腳本在模型環境外部執行:
| 評估指標 | 規則調整前 | 規則調整後 | 差異幅度 |
|---|---|---|---|
| 任務耗時 | 59.72 秒 | 60.71 秒 | 基本持平(+1.6%) |
| 累計輸入 Token | 80,598 | 69,252 | 減少約 14.1% |
| 其中快取輸入 | 66,048 | 62,080 | 減少約 6.0% |
| 外部獨立驗收 | 4/4 項全部通過 | 4/4 項全部通過 | 完全一致 |
實驗洞察:
兩組輸出的程式碼品質與功能完全一致。新規則省去了不必要的規則讀取,輸入 Token 確實減少了 14%,但在這種短平快任務裡,耗時幾乎沒有差異。
瘦身規則確實能省下不必要的上下文開銷,但指望「改兩行規則就讓速度翻倍」,在現實中並不成立。
四、 任務變難,Astra 會不會出現「成本反轉」?
很多人(包括我自己一開始)都有一個合理猜想:
「Astra 雖然單價貴了 2.5 倍,但只要任務足夠複雜,它靠更強的智商少走彎路、少寫廢話、少試錯幾輪,總帳會不會反而比 Sol 更省?」
為了檢驗這個猜想,我們在固定新規則的前提下,準備了一個合成的 SQLite 離線便籤同步專案:
- 中檔任務:修復傳送失敗與確認丟失後的重試機制;
- 高檔任務:疊加亂序事件、刪除墓碑標記與事務回滾,需要跨多個核心模組協同排查。
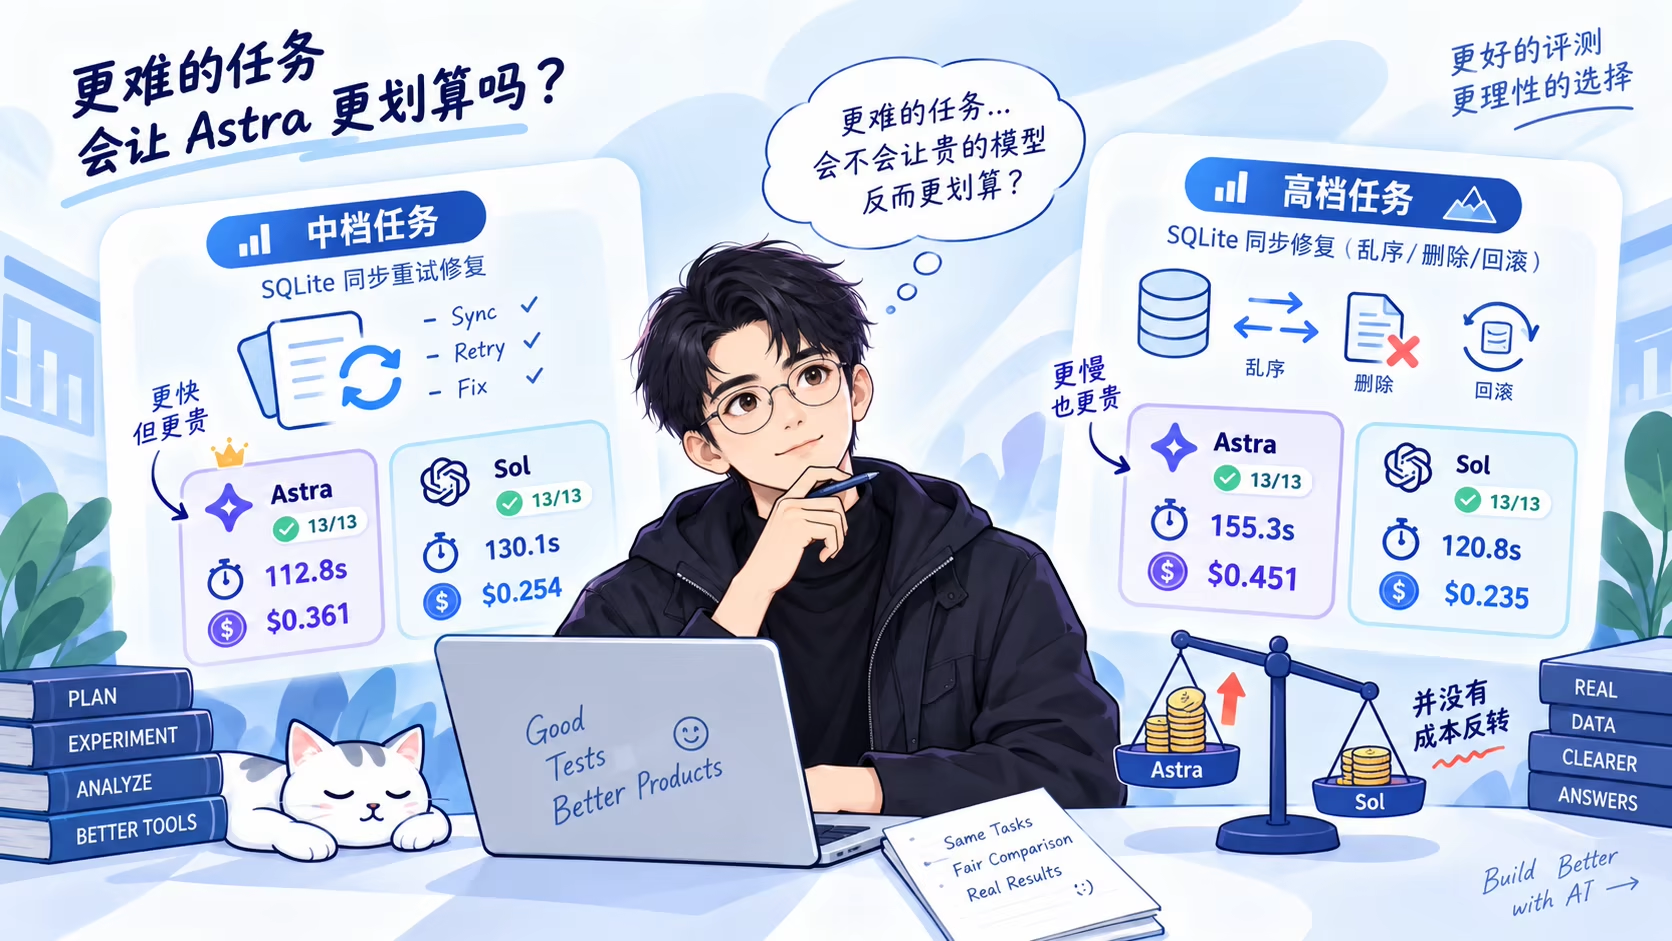
兩邊統一使用 Low 檔,單次執行上限 8 分鐘,外部執行 13 項獨立用例。結果如下(金額按官方標準 API 費率等值折算):
| 任務難度 | Astra/Low 耗時與等值成本 | Sol/Low 耗時與等值成本 | 獨立驗收通過率 | 核心差異解讀 |
|---|---|---|---|---|
| 中檔重試修復 | 112.8 秒 / $0.361 | 130.1 秒 / $0.254 | 兩組均 13/13 | Astra 快 13%,但費用高出 42% |
| 高檔同步修復 | 155.3 秒 / $0.451 | 120.8 秒 / $0.235 | 兩組均 13/13 | Astra 反慢 29%,費用高出 92% |
關鍵實驗結論(猜想被打破):
高難度任務下,並沒有出現「智商換總帳更省」的成本反轉。
雖然在程式碼審查中發現 Astra 在高檔任務裡更嚴謹地補充了版本號必須為整數的校驗,但在功能性驗收都通過的前提下,Astra 的綜合等值帳單依然比 Sol 貴了 42% 到 92%。
以上兩組都是單次實測(n=1),每組只跑了一次。
五、 算帳科普:Codex 訂閱與 API 計費的重大資訊落差
計算費用時,很多人容易把 「Codex 訂閱使用者的額度」 與 「底層 API 的美元扣費」 混為一談。
必須認清以下三組核心規則的區別:
1. 缓存命中(Cached Input):按 API 标准价,Astra 的缓存输入为 $1.00/1M,是普通输入的 1 折。
2. Codex 计费规则:OpenAI 在 Help Center 里给 Codex 里的 Astra 开了例外,不收缓存写入费,输入超过 272K 也不追加长上下文倍率。
3. 底层 API 阶梯加价:自己调底层 API 时,单次输入一旦超过 272K,整单(不只是超出部分)输入和缓存按 2x、输出按 1.5x 计费。
我們用一個靜態測算例子看看兩者的差距。假設處理同一次輸入 300K(其中 270K 命中快取,30K 未命中)、輸出 5K 的大型請求:
| 計價環境與場景 | Astra 等值花費 | Sol 等值花費 | 價差倍數 | 規則影響說明 |
|---|---|---|---|---|
| 標準 API(假設無倍率) | $0.820 | $0.328 | 2.5 倍 | 基礎單價決定的固定倍率 |
| 標準 API(實際超 272K) | $1.515 | $0.606 | 2.5 倍 | 整單加收 2x 輸入與 1.5x 輸出倍率 |
| Codex 工作區計費(享豁免) | $0.820 | $0.606 | 僅約 1.35 倍 | Astra 豁免了超限倍率,兩者差距顯著縮小 |
注:按 2026 年 9 月價格計算,每百萬 token:Astra 輸入 $10、快取 $1、輸出 $50;GPT-5.6 Sol 按我當時看到的價格算,輸入 $4、快取 $0.4、輸出 $20(發布價是 $5/$30)。表中只算輸入、快取讀取和輸出,沒算快取寫入。Codex 裡的 Astra 計費例外見 OpenAI Help Center 的說明。10 月之後 OpenAI 又調整了 Sol 的價格,現在再算差距會更大。
這就是為什麼官方頁面會說 Astra 的「每任務估算 API 成本低於更早的模型,儘管每 token 單價更高」:如果任務極度困難,Astra 能把 Token 壓縮到極低,加之 Codex 的計費政策,確實有理論反超空間。
但在我們日常幾百行程式碼的中大型開發中,Token 並沒有少到足以抹平單價鴻溝。
六、 真實體感:即使開著 Low,額度依然掉得飛快
在排除掉理論測算後,講講最真實的肉身感官。
9 月 6 日下午,我的開發強度已經明顯放緩,中午剛用了一張重置卡,到晚上接近 12 點,5 倍的周額度又跌到了只剩 20% 出頭。期間還有數個小時我完全離開了電腦,並未連續高頻提問。
即使用著 Astra 最低檔的輕度推理(Low),它的周額度消耗速度依然肉眼可見地快。
每當看到用戶端右上角的額度百分比急劇下跌時,我都會被迫停下來重新評估:手頭這個任務,到底配不配用 Astra?
在日常的大多數場景下,它帶來的速度提升固然爽快,但程式碼最終的交付品質並沒有比調教好的 Sol 拉開檔次。面對如此嚴峻的額度折損,把 Astra 設為全天候的「預設模型」,價效比確實不算高。
七、 建議收藏:不同任務的模型與思考強度建議表
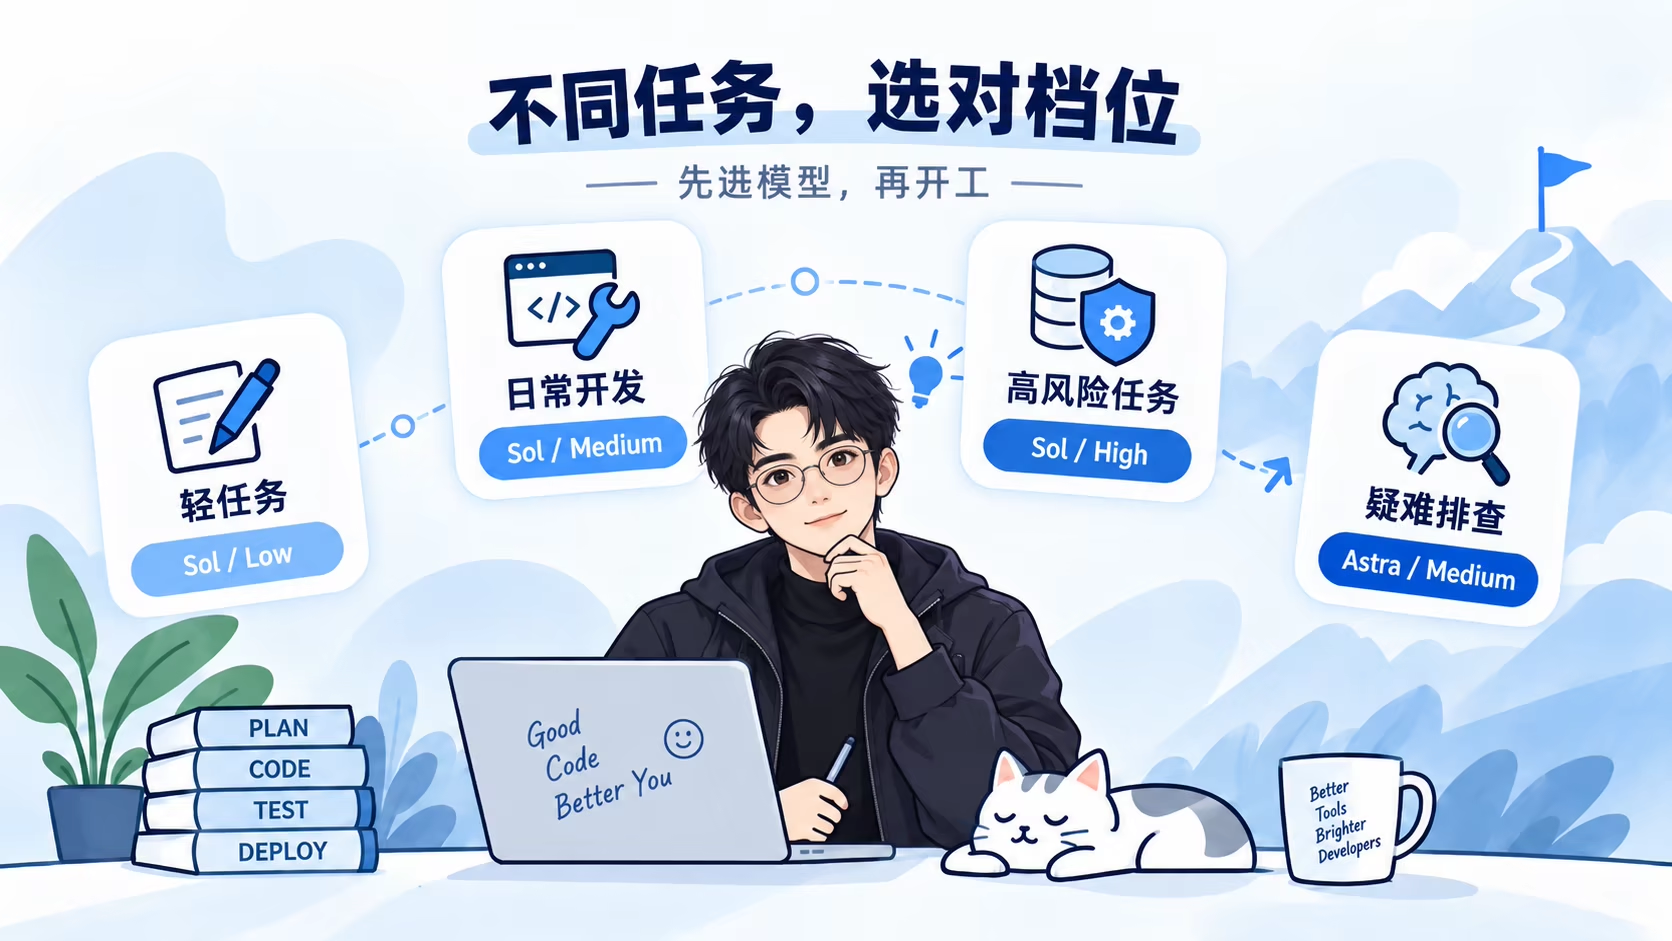
為了避免每次開工都在選單裡猶豫不決,我結合實測資料與官方特性,給自己收斂出了下面這張「開工決策表」:
| 任務場景與特徵 | 建議預設模型與思考強度 | 決策理由與升級條件 |
|---|---|---|
| 文案、樣式、設定、小重構 | Sol/Low | 要求明確,追求秒級響應與零廢話,堅決不上大炮 |
| 日常功能開發、常規 Bug 排查 | Sol/Medium | 日常主力預設檔,推理充分且兼顧返工風險 |
| 認證鑑權、資料庫遷移、核心狀態機 | Sol/High 起步 | 高返工成本任務,先確認方案邊界與驗證範圍 |
| 補充充分證據後仍反覆找錯根因 | 升級至 Astra/Medium | 現有模型反覆打轉、邏輯卡死時,才值得呼叫 Astra 攻堅 |
開工一句話記憶原則:
日常開發從 Sol/Medium 開始;任務輕量降到 Low;補足材料現有模型依然找不到方向,再切到 Astra。
寫在最後
好工具不等於每時每刻都要開到最高擋位。把最貴的武器留給真正的硬仗,把平穩的輸出交給價效比成熟的組合,才是長期工程生產力的最優解。
另外,針對 Astra「過於聽話易死鎖、易過度測試」的行為特點,我目前正在本機工程裡打磨一套專為它定製的最新版全域約束檔案 AGENTS.md。
先不急著拋出未經驗證的半成品,等我帶著複雜專案再重度跑上一兩週,如果實測確認這套規則能穩定幫大家防卡死、降返工並省下額度,我會把這套打磨好的最新版 AGENTS.md 完整開源分享出來給大家抄作業。