大家好,我是 Ward。今天這篇文章接著上篇,聊聊我把手頭的 5 大 AI 訂閱接進開源閘道器 Magpie 後,如何藉助 Jev 意圖模型,根據手頭訂閱情況推翻舊設定、重構多模型路由規則的實戰經歷。
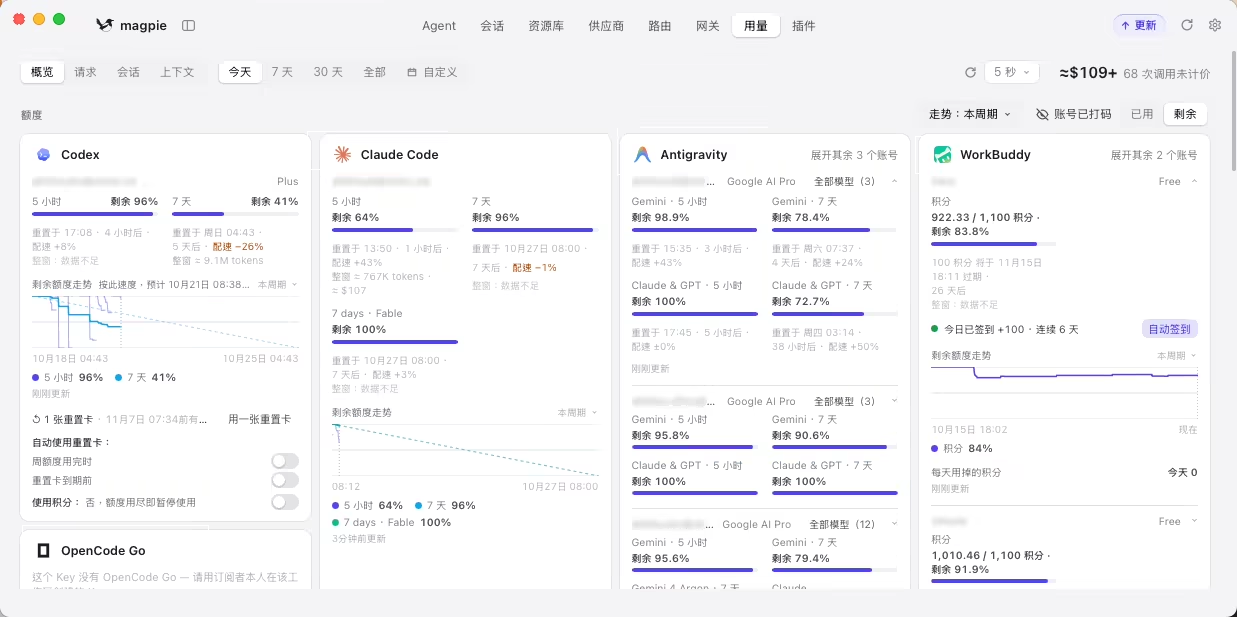
上一篇聊到我把 CC-Switch 和 AntiGravity Tools(原 AntiGravity Manager)換成了開源 AI 閘道器 Magpie(Magpie GitHub 地址:yetone/magpie)。安裝好之後,我把我的 Codex、Claude Code、OpenCode Go、Google AI Pro(Antigravity)訂閱以及 WorkBuddy 都接了進去。
設定著設定著,我發現它的路由模式裡面還支援接入意圖模型。這樣我就想起來前段時間比較火的 TypeSafe Jev 模型(typesafe/jev-latest),於是把這個模型也接了進來,用來給我判斷每一輪該用什麼模型以及用什麼推理強度(effort=auto)。
不過這個路由該怎麼配呢?我自己也不懂,看著有點複雜。我是直接把官方文件(Magpie 意圖路由官方文件)丟給 AI,讓它根據我手頭訂閱情況和對各個模型的使用方向來幫我設定。
前前後後,我這個路由模式按大的版本算一共改了兩次,現在用的是第二版。
預計閱讀 8 分鐘|導讀與核心大綱
本文是手頭 5 大訂閱接入 Magpie 閘道器治理的中篇實戰。基於 4600+ 請求日誌覆盤,聚焦意圖路由重構與額度防踩雷隔離:
- 01. 第一版踩雷覆盤:18 個模型順次滑落、子代理吃空 Opus 主額度的致命缺陷
- 02. 第二版拓撲重構:按業務場景切分的 4 大路由組(Coder / Deep / Review / Fast)
- 03. 審查切換踩雷與修復:Agent 槽位硬繫結真相,以及主力程式設計組規則的單點打通
- 04. 實測效果與下篇預告:兩輪重構後的實際流轉體感,以及更大的日誌盲點
為什麼第一版 5 個路由組用起來效果很差?
第一輪配完的時候,AI 幫我分了 5 個路由組(intent-coder、intent-deep、intent-fast、intent-visual、intent-auto)。用了幾天我感覺那個路由模式不太好,沒有把各個模型的優勢發揮充分。很多事情最後都交給一些比較差的模型去做了,寫出來的程式碼效果自然也比較差。
改第二版之前,我讓 AI 結合閘道器裡 4600 多條請求日誌分析了一下我實際使用的模型情況,才看清楚第一版到底差在哪兒。
第一點是每個組都把 18 個模型按順序塞在一個列表裡(routing=order),從頂部的 Opus 一直排到底部的免費 Flash 模型。前幾天 Codex 模型有一陣子狀態不對被跳過(出現了約 2600 次 unlisted),等到 Claude 的 5 小時視窗額度一滿觸發限流,哪怕命中了「複雜架構設計、安全審計」這種高難度規則,請求也會順著列表滑到底部,有 860 多次直接落到了 workbuddy/deepseek-v4.1-flash 和 gemini-3.8-flash 上面。本來該用主力大模型乾的重活,結果全交給輕量級模型去做了。
第二點是子代理(subagents)把主模型的額度吃光了:第一版把子代理綁在了 intent-auto 組,這個組排第一的是 claude/claude-opus-5-5,而且當時還開著 ultracode。日誌統計下來,5 小時窗口裡一共 255 次 Claude 請求,有 195 次(佔了 76%)都是後臺搜檔案、讀程式碼的子代理發出去的,導致我主對話寫程式碼時反而沒額度可用。
第三點是看圖規則的粘性問題:第一版配了 images → antigravity/gemini-3.8-flash 並且預設帶了 stays=auto,只要對話歷史裡發過一張截圖,後面整場對話就一直停在 gemini-3.8-flash 上不往回切,一共觸發了 300 多次;反倒專門建的 intent-visual 組一次都沒走過。
另外我也讓 AI 抽樣檢查了 248 輪 Jev 模型的 effort=auto 強度判斷。因為 Jev 只看當前這一輪輸入的字面內容,如果前面剛聊完複雜方案,我只回一句「繼續」或者「同意」,它經常會給成 low;而遇到帶了大段 <system-reminder> 的系統訊息,又容易給成 high 或 xhigh。所以路由組本身的模型排隊順序必須守住底線,不能全指望單輪分類。
結合方案變化,第二輪把 5 個路由組縮減為 4 個
這一輪大改,除了前面說的模型沒發揮出優勢之外,也和我的訂閱方案發生改變有關係。
我在剛開始用 Magpie 的那幾天,Codex 還是高一檔的訂閱,當時的主力模型是 codex/gpt-6.1-sol。後面這個訂閱到期,我就降了一檔(保留 gpt-6.1-sol、gpt-6-astra 和 gpt-6-luna)。Claude Code 是我 10 月 15 日才開通的,一開始訂的是低一檔,後面升到了高一檔。Claude Code 這個訂閱我個人前後一共花了 125 刀(含渠道費用)。所以現在我的主力模型就變成了 Claude Opus 5.5(外加 claude-fable-5-1、sonnet-5-5 和 haiku-5-5)。
因此在第二輪讓 AI 給我做改進方案時,我特別強調了兩點,一是主力已經換成了 Opus 5.5,二是一定要把各個模型的優勢發揮出來,不能再讓差模型去幹核心活兒。
當時我電腦上還開著 12 個正在幹活的 Claude Code 終端。為了不讓這些執行中的會話因找不到舊路由組 ID 而報錯中斷,AI 直接複用了原來的 4 個 ID,刪掉了 0 請求的 intent-visual,把 5 個路由組縮減成了 4 個路由組。
改完之後這 4 個組大概是這麼分的(2026 年 10 月的設定)。
主力程式設計這組(group/intent-coder)給 Claude Code 當預設模型,也佔著 opus 槽位。排第一的是官方的 claude/claude-opus-5-5,5 小時視窗限流了的話,就輪到 4 個 Google AI Pro 帳號輪詢的 antigravity/gemini-4-argon(1M 上下文)和 antigravity/claude-opus-5-5,再往後是 claude-fable-5-1,墊底那些免費小模型我全刪了。這組還配了兩條規則,上下文壓縮(compacting)丟給 gemini-3.8-flash,碰到複雜架構設計或者跨模組重構,就切到 claude-fable-5-1。
架構設計那組(group/intent-deep)綁的是 fable 槽位,claude/claude-fable-5-1 推理比較深,就放第一個,claude/claude-opus-5-5 和 gemini-4-argon 跟在後面。
審查專線(group/intent-auto)我綁給了 Claude Code 的 sonnet 槽位,還有 Codex CLI 的主模型。Codex 雖然降了一檔,但 codex/gpt-6.1-sol 和 codex/gpt-6-astra 拿來審程式碼、給方案挑錯還是挺好用的。平時 gpt-6.1-sol 打頭,Jev 看出來是在審方案、查漏洞的時候,再切給 codex/gpt-6-astra。
剩下一組是快速與子代理(group/intent-fast),haiku 槽位和 Claude Code、Codex 的子代理 subagents 都走它,ultracode 我也順手關了。子代理平常就是搜搜檔案、跑個小腳本,交給 4 個號輪詢的 antigravity/gemini-3.8-flash、haiku-5-5,再加上 WorkBuddy 簽到後可用的 deepseek-v4.1-flash、glm-5.3-flash 就夠了,這樣就不會再去吃 Opus 的額度。
第二版用了一天多,發現審查專線根本切不過去
第二版用了一天多,我發現 Claude Code 好像老是停在「主力程式設計」這個組裡。我讓它 review 方案,甚至直接說用 GPT-6 Astra、Claude Fable 5.1 來 review,它也不往「審查專線」那邊切。
我第一反應是之前 5 個組的舊資料沒清掉。因為印象裡第一版的時候它還挺常切過去的,改成 4 個組以後就很少了。結果讓 AI 去翻了設定和日誌,又對著官方文件看了一遍,發現是我自己把路由組想錯了。
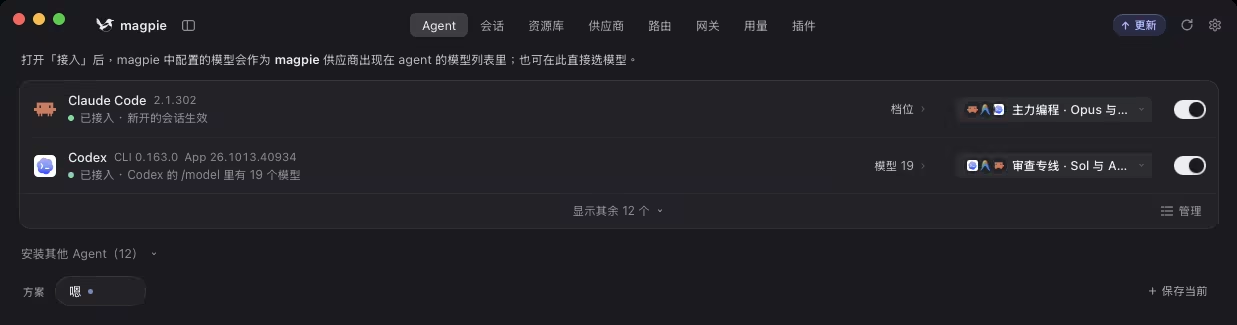
我原來以為它會按意圖在幾個組之間跳來跳去,其實不是。路由組是跟 Agent 的模型槽位綁死的:Claude Code 的主對話永遠走 model 槽位,我這個槽位綁的是 group/intent-coder,那主對話發出去的請求就只會進主力程式設計組。審查專線綁在 sonnet 槽位上,主對話壓根就碰不到它。
那在組裡面能不能切呢?可以,但 Jev 判出來的規則只能在當前這個組的成員裡挑,規則後面也只能寫一個具體模型(provider/model),寫不了另一個 group/<id>。偏偏我第二版的主力程式設計組裡就沒放 gpt-6-astra,review 相關的規則也一條沒配,我說得再清楚它也沒地方切。
還有架構設計那條規則,也寫得太死:AI 當時在 Fable 的意圖後面又加了一長串「不涉及常規寫程式碼、修 Bug、單點修改、測試或 Git 部署操作」的排除條件,Jev 一看基本都判成沒命中。日誌統計下來,第二版之前規則命中率大概是 53%,改成第二版之後掉到了 7.5%。沒命中規則的時候,就按組裡的順序加上 prompt cache 的親和留在 Opus 上,看上去就像「一直停在主力程式設計」。
所以其實不是舊資料的問題,是第二版設定本身有缺陷。
我順著這個問題還想了一下,那其實主對話這塊我只需要一個路由組就夠了,把要用的模型都放進主力程式設計組,再靠規則去分就行。最後的改法也是這樣,主要改了主力程式設計組 group/intent-coder 這一個組,其他幾個組繼續留給 fable、haiku、子代理和 Codex CLI 用。
- 把
codex/gpt-6-astra加進主力程式設計組的成員裡。 - 新加一條審查規則,意圖寫的是「審查、評審或 review 已有的技術方案、架構設計、程式碼改動、PR 或資料庫遷移方案,找出問題和風險;或明確要求用 Astra / GPT 來審查」,命中就切給
gpt-6-astra。 - 把
Fable那條規則的排除條件刪掉,改成「設計系統架構、跨模組技術方案或核心技術選型,或規劃一個較大功能的整體實現方案;或明確要求用 Fable 來設計」。
改之前 AI 先把 providers.json 備份了一份,改完我又讓它查了一下日誌。在另一個專案裡我發了一條 review 方案的訊息,Jev 用了 1 秒左右判成審查規則,這一輪直接由 gpt-6-astra 來回答,後面二十多次工具呼叫也一直留在 Astra 上,沒有中途換回 Opus。
中間也碰到一次小插曲。Astra 有一次回覆到一半連線斷了(Codex: connection lost mid-reply (unexpected EOF)),Magpie 就讓它先休息了一分半鐘左右。剛好這時候我又發了一條審查請求,規則其實命中了,但因為 Astra 還在退避期,就退回到組裡排第一的 Opus 來回答。這個是出錯之後的保護機制,不是設定的問題,等退避時間過了就會切回去。
另外 Fable 那條架構規則,改完之後我還沒有真正發過架構設計的問題,所以還沒在日誌裡驗證到。
未完待續:以為大功告成,日誌體檢卻抓出了更大盲點
折騰到這一步,我原以為這套拓撲終於打磨得嚴絲合縫、大功告成了。
然而第二天,我讓 AI 對著閘道器裡最新的幾千條請求日誌做全量體檢時,沒想到又抓出了更讓人意想不到的「順位盲點」:整整 942 次高難度請求,在 Astra 額度完全充足的情況下,居然被排在 Astra 前面的 Flash 模型給硬生生「截胡」了!
不僅如此,這次體檢還促使我徹底反思起在同一個主會話裡切模型的侷限,並最終做出了一次大手術:把審查徹底踢出主路由,做成了獨立的跨家族對抗子代理,並把全域門禁制度化寫進了工程規範。
具體的日誌體檢覆盤、942 次隱性降級真相,以及最終的跨家族審查子代理與工程門禁設計,我們在下篇接著聊。