目录
大家好,我是 Ward。今天这篇算是 Magpie 网关调优的终结篇了。
前两篇讲过,我把手头几份 AI 订阅都接进了 Magpie(GitHub: yetone/magpie),用 Jev 意图模型按业务分了组。中篇最后留了一个悬念:日志体检抓出 942 次高难度请求被弱模型截胡了。这一篇接着讲这件事怎么查出来,又怎么改。
中篇写完那会儿,我图省事,顺手把 codex/gpt-6-astra 塞进了主力写代码的组里,配了条审查规则,当时想的是这样可能会比较方便。
结果后面我拿它写代码,才发现不太对劲,额度掉得太快了。
随后我让 AI 分析一下近期 Magpie 日志,看看实际情况是怎样的,路由是否准确且合理。结果又发现不少问题,下面和大家分享下我踩的坑,以及我是如何进行优化的。
主力组大折腾:顺位排错、额度互抢与彻底瘦身
尴尬的 Astra:先是 942 次没用上,用上后才发现根本用不起
这里面最折腾的,其实是 codex/gpt-6-astra 这个模型。对于我手头这档 Codex 订阅来说,它的定位极其尴尬:放主力组不耐用,放审查组也经不起耗,我根本用不起。
整个过程也挺戏剧化:一开始是“为什么完全没用上”。当时我把它顺手排在主力组列表末尾(Opus → Argon → AG Opus → Fable → Flash → Astra),以为平时写代码用不上,排末尾兜底肯定没事。结果一翻日志傻眼了:全天有 1,030 次主力写代码请求一路滑到了排在 Astra 前面的 gemini-3.8-flash 身上,而这里面整整 942 次发生的时候,Astra 的额度明明满血可用!原因很简单,因为我设置的规则是按顺序走,Flash 排在 Astra 前头,前面的额度一旦耗尽,网关碰见 Flash 活着就直接抓来干活了,根本轮不到最后面的 Astra,花钱买的高推理模型白白被轻量弱模型截胡了 942 次。
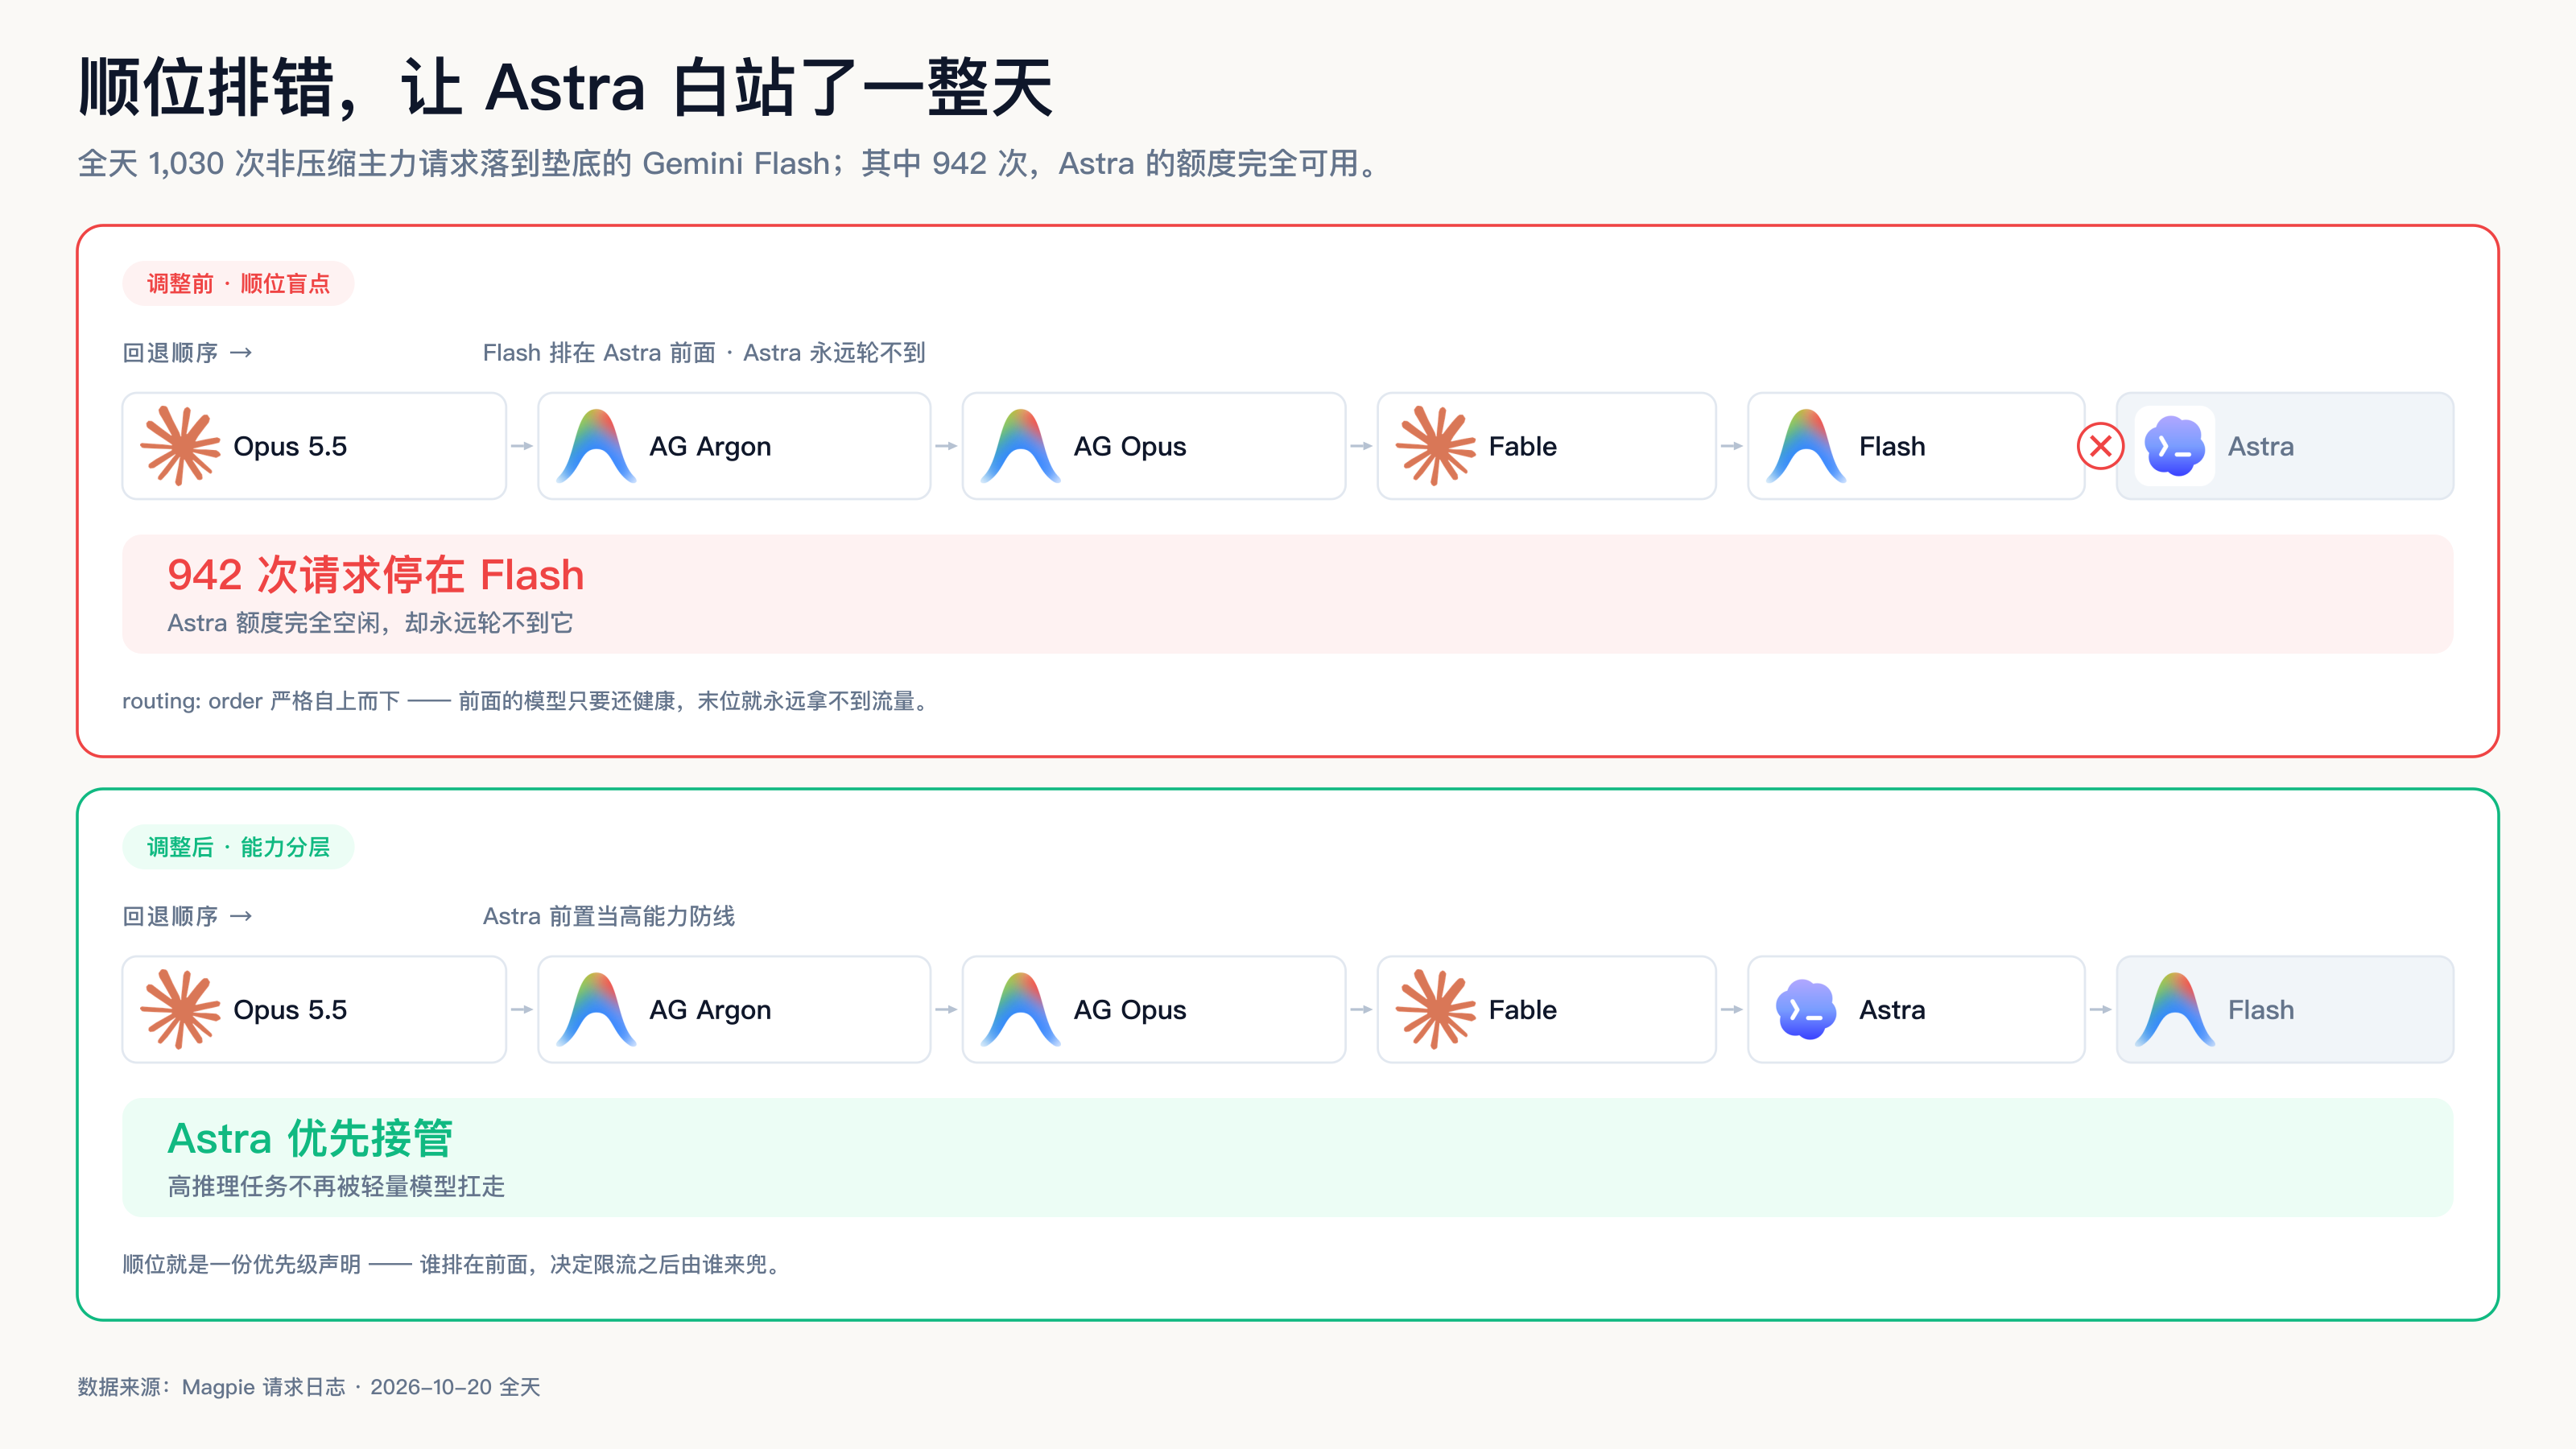
抓到这个漏洞后,我第一反应是把顺位往前挪(改成 ... Fable → Astra → Flash)。但真正把流量放进去后,才迎来了后半段更严重的问题:我根本用不起。
因为这档 Codex 订阅的 5 小时额度其实非常吃紧。主力 Claude 额度一旦见底,顺位直接跌落给 Astra,主对话里写代码、翻文件、查上下文这些吃 Token 的脏活累活全倒给了 Astra,几下子就把窗口额度彻底冲爆了。更尴尬的是两边打架:有好几次我明明提问让它审代码,规则也对上了,结果回话的居然还是 Opus。翻日志一看才明白,写代码早就把 Astra 额度干光了进入退避期,Magpie 只能灰溜溜退回第一顺位的 Opus 来保底。写代码把审方案的额度霍霍了,审方案反过来又去抢写代码的额度。不管是写代码还是做审查,Astra 在这档订阅下都极不耐用。在同一个会话里靠规则切来切去,简直是自己给自己挖坑,这也让我最终下定决心:主力组和后续的审查,都彻底放弃 Astra,一个都不用。
移出 Fable:警惕缓存亲和性偷偷扣额度
至于 Fable,更是让我大跌眼镜。
原本我在主力组里加了 Fable 的架构规则。结果一查缓存,整个人都麻了。Magpie 有个缓存亲和机制,会拼命锁住上一次命中的模型来保 Prompt Cache。
长会话里只要有一句不小心碰到了 Fable,后头哪怕我问一句最简单的找 Bug,它也死乞白赖继续走 Fable。日志里清清楚楚记着,短短 11 次调用,消耗了约 49 万缓存写入 tokens 和约 108 万缓存读取 tokens。我的那点额度,哪经得起这么造。
主力组彻底瘦身,追加 DeepSeek 兜底
所以我想通了,主力组就干主力组的事,别整那些花里胡哨的。
我二话不说,把 Astra 和 Fable 连同所有复杂的意图规则全部清空。写代码老老实实走 Opus,Opus 额度见底了交给便宜大碗的 Gemini Flash。
为了防暴毙,我还把 WorkBuddy 每天签到领的「赛博鸡蛋」DeepSeek Flash 挂在最后兜底。
这块确实有用。之前,几个主力模型全被限流卡死,网关直接报了全军覆没的 400 错误。加上 DeepSeek 之后,整晚一次 400 报错都没出现了。
审查单独拎出来,搞跨家族对抗
把写代码和审查混在同一个会话里行不通,我就开始琢磨怎么把审查单独拎出来。其实审代码这事,本身就不应该让写代码的模型自己来干。
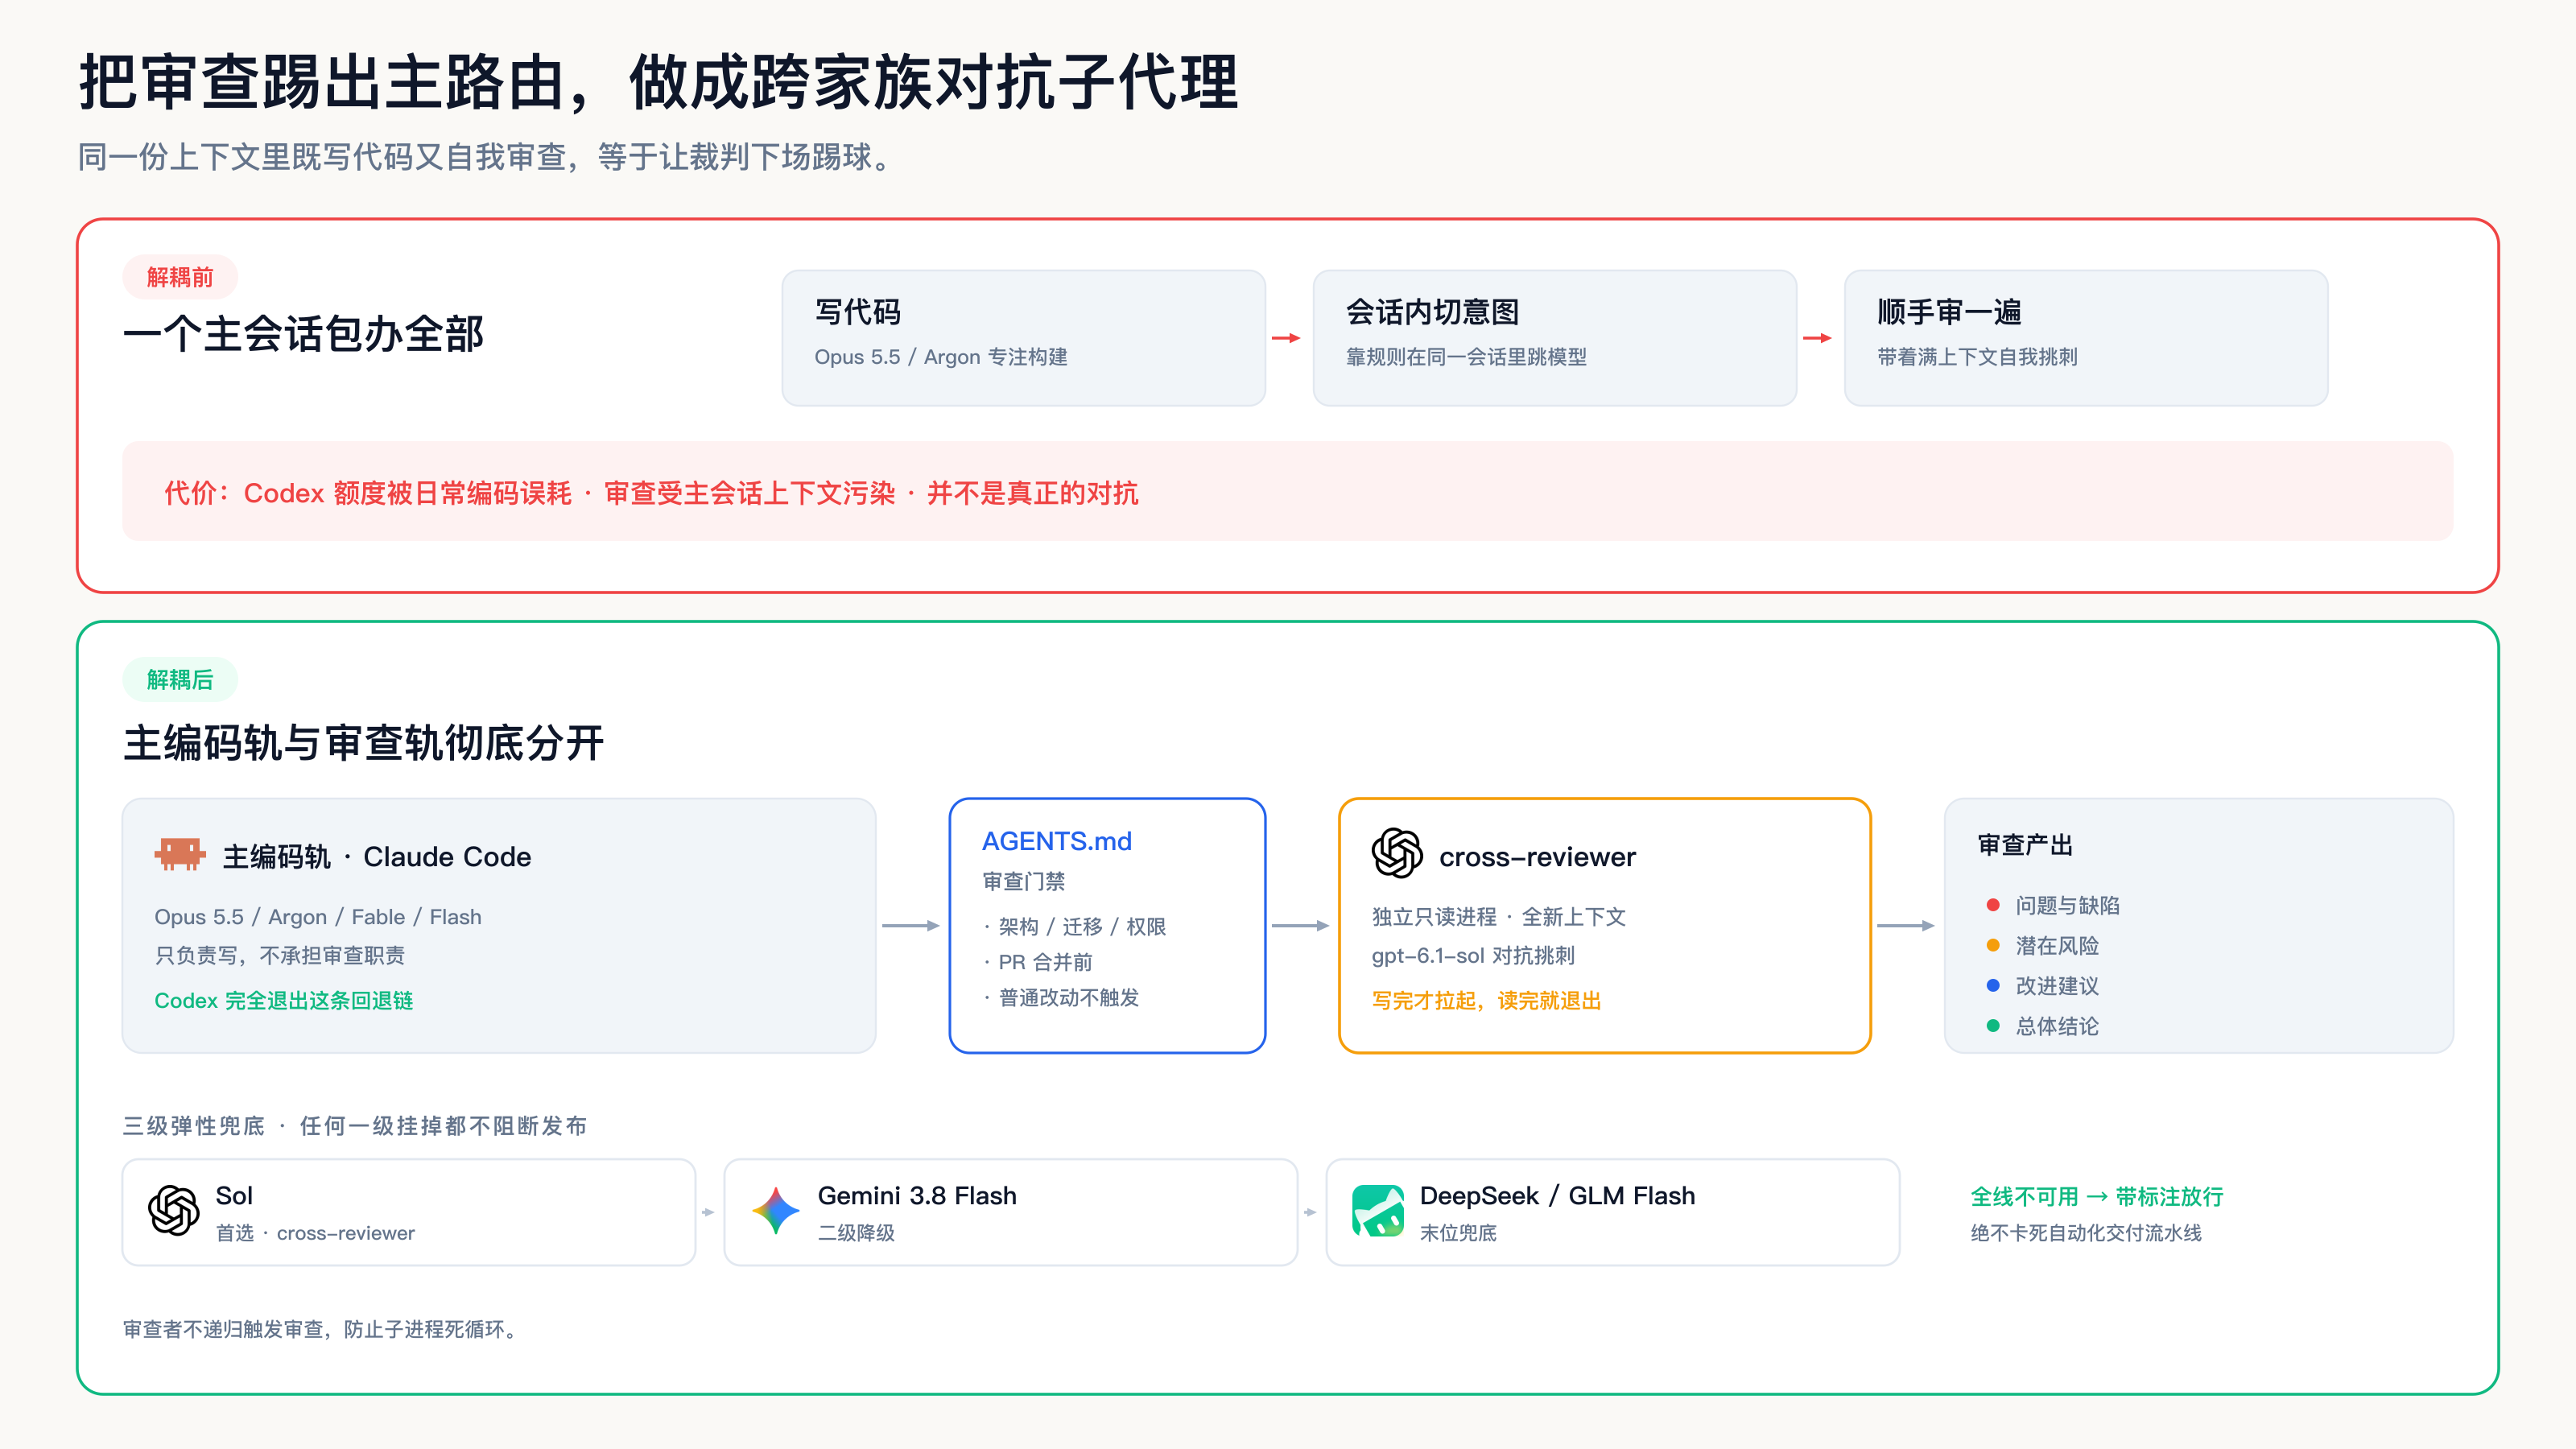
你想啊,平时我们让 Claude 写代码,写完又让它自己 review,或者顺位滑给同一个公司的其他模型来审,这不就是自己人审自己人吗?同一个公司的模型,代码习惯和偏好都差不多,甚至习惯顺着你的思路往下编,真有边界漏洞或者并发死锁,它根本挑不出来。
审查就得找对立阵营的来挑刺。主对话既然是 Anthropic 家族的 Claude 在写,审查就换成 OpenAI 阵营的 Codex,天然对彼此的代码不客气。
我新建了一个只读的审查子代理(cross-reviewer),用全新的独立进程启动,不带主会话的历史上下文包袱,只拿当前的改动和代码做纯粹的逻辑推演,专找并发竞态、死锁和边界死角。
那换哪个模型来挑刺呢?我一开始确实想用 Astra,但用了段时间发现,Astra 实在太费额度了,后来我调成了 codex/gpt-6.1-sol。
换了之后效果真不错。GPT 6.1 Sol 这个模型现在性价比挺高,找起 Bug 来看得很毒辣,关键是又快又省。我翻了 10 月 21 日全天的日志,总共触发了 105 次审查,全都被 Sol 稳稳吃下来了,没报过一次错。而且这里面有 630 多万 tokens 都吃到了缓存读取,真正算钱的输入才 17 万 tokens,回答输出也特别干练,一共才 5,000 多 token,折算下来才花了 0.81 美元左右。
不过为了不让它动不动就出来指指点点,我顺手在项目的 AGENTS.md 里加了个门禁规则。平时改个小样式、修个错别字绝不叫它,只有在重构系统架构、动数据库表结构、改安全鉴权或者提 PR 的时候,才会强制拉起这个子代理来挑刺。要是遇到网络抖动或者模型挂了,顺位降级给 Gemini 3.8 Flash,再不行就用 WorkBuddy 的免费 DeepSeek 垫底。要是实在都不行,就带个标记放行,总归不能把自己的自动化流水线给卡死。
手头 4 个 Google 账号自动轮换,再用插件处理假 429
除了写代码和审查,手头的 4 个 Google AI Pro(Antigravity)账号也要高效地利用起来。
以前用 Agy CLI,最麻烦的就是其中一个账号额度用光了,我必须手动点击退出登录,再一步步输入账号密码重新登录下一个号,写代码的心流全被打碎了。
在 Magpie 里面其实完全不需要这么折腾。我单独建了一个 antigravity 路由组,调度策略设为 routing: "rotate",亲和性设为 affinity: "session"。这样它在后台会自动轮流调度我这 4 个 Google 账号,同一个会话内部锁在一个账号上保缓存,新会话就轮转开。
成员纯化为 4 个 Antigravity 官方模型(Flash、Sonnet 5.5、AG Opus、Argon),专心消耗 4 个账号的官方额度池,给我在写作、生成视频以及一些需要大量 token 的场景使用。10 月 21 日这个组跑了 1,112 次调用,4 个账号在后台安安静静轮换,我再也没手动切过号。
此外,用 Antigravity 的朋友应该经常在 Claude Code 或者 Claude Desktop 遇到过 429 Resource has been exhausted 报错。大家第一反应都是额度没了,但我翻了日志里的错误堆栈才发现根本不是,网关明确写着:
Antigravity answers this 429 to the system prompt of Claude Code and the Claude Agent SDK (Claude Desktop's chats) whatever quota is left, so it is not a quota and waiting won't help.
说白了,只要发出去的系统提示词含有 Claude 客户端的特征词,Antigravity 就会直接丢出 429 拒掉,哪怕账号剩余额度是满的。之前我日志里这种假 429 累计被拦截了 289 次。
社区里有人为此做了一个插件(Antigravity Cloak)。它的实现细节我这里不展开。装上之后,全天后续 2,670 多次请求里,假 429 一次都没再出现过,Claude Code 顺畅分流给 Gemini Flash 正常返回。
不过这里也要说清楚风险:这类插件会改动发给服务商的文本,可能违反 Antigravity 的服务条款,账号有被封的风险;Google 改了规则之后,效果也可能失效。我自己的账号之前也被封过,后面自动解封了。所以我的建议是只用于备用账号,保守方案仍是把 Antigravity 放在回退链靠后的位置。
调整后的 5 大路由组与全天实测数据
中篇时还是 4 个路由组,这一轮调整后,网关最终稳定收敛为 5 大路由组,多出来的是 antigravity 轮转组。
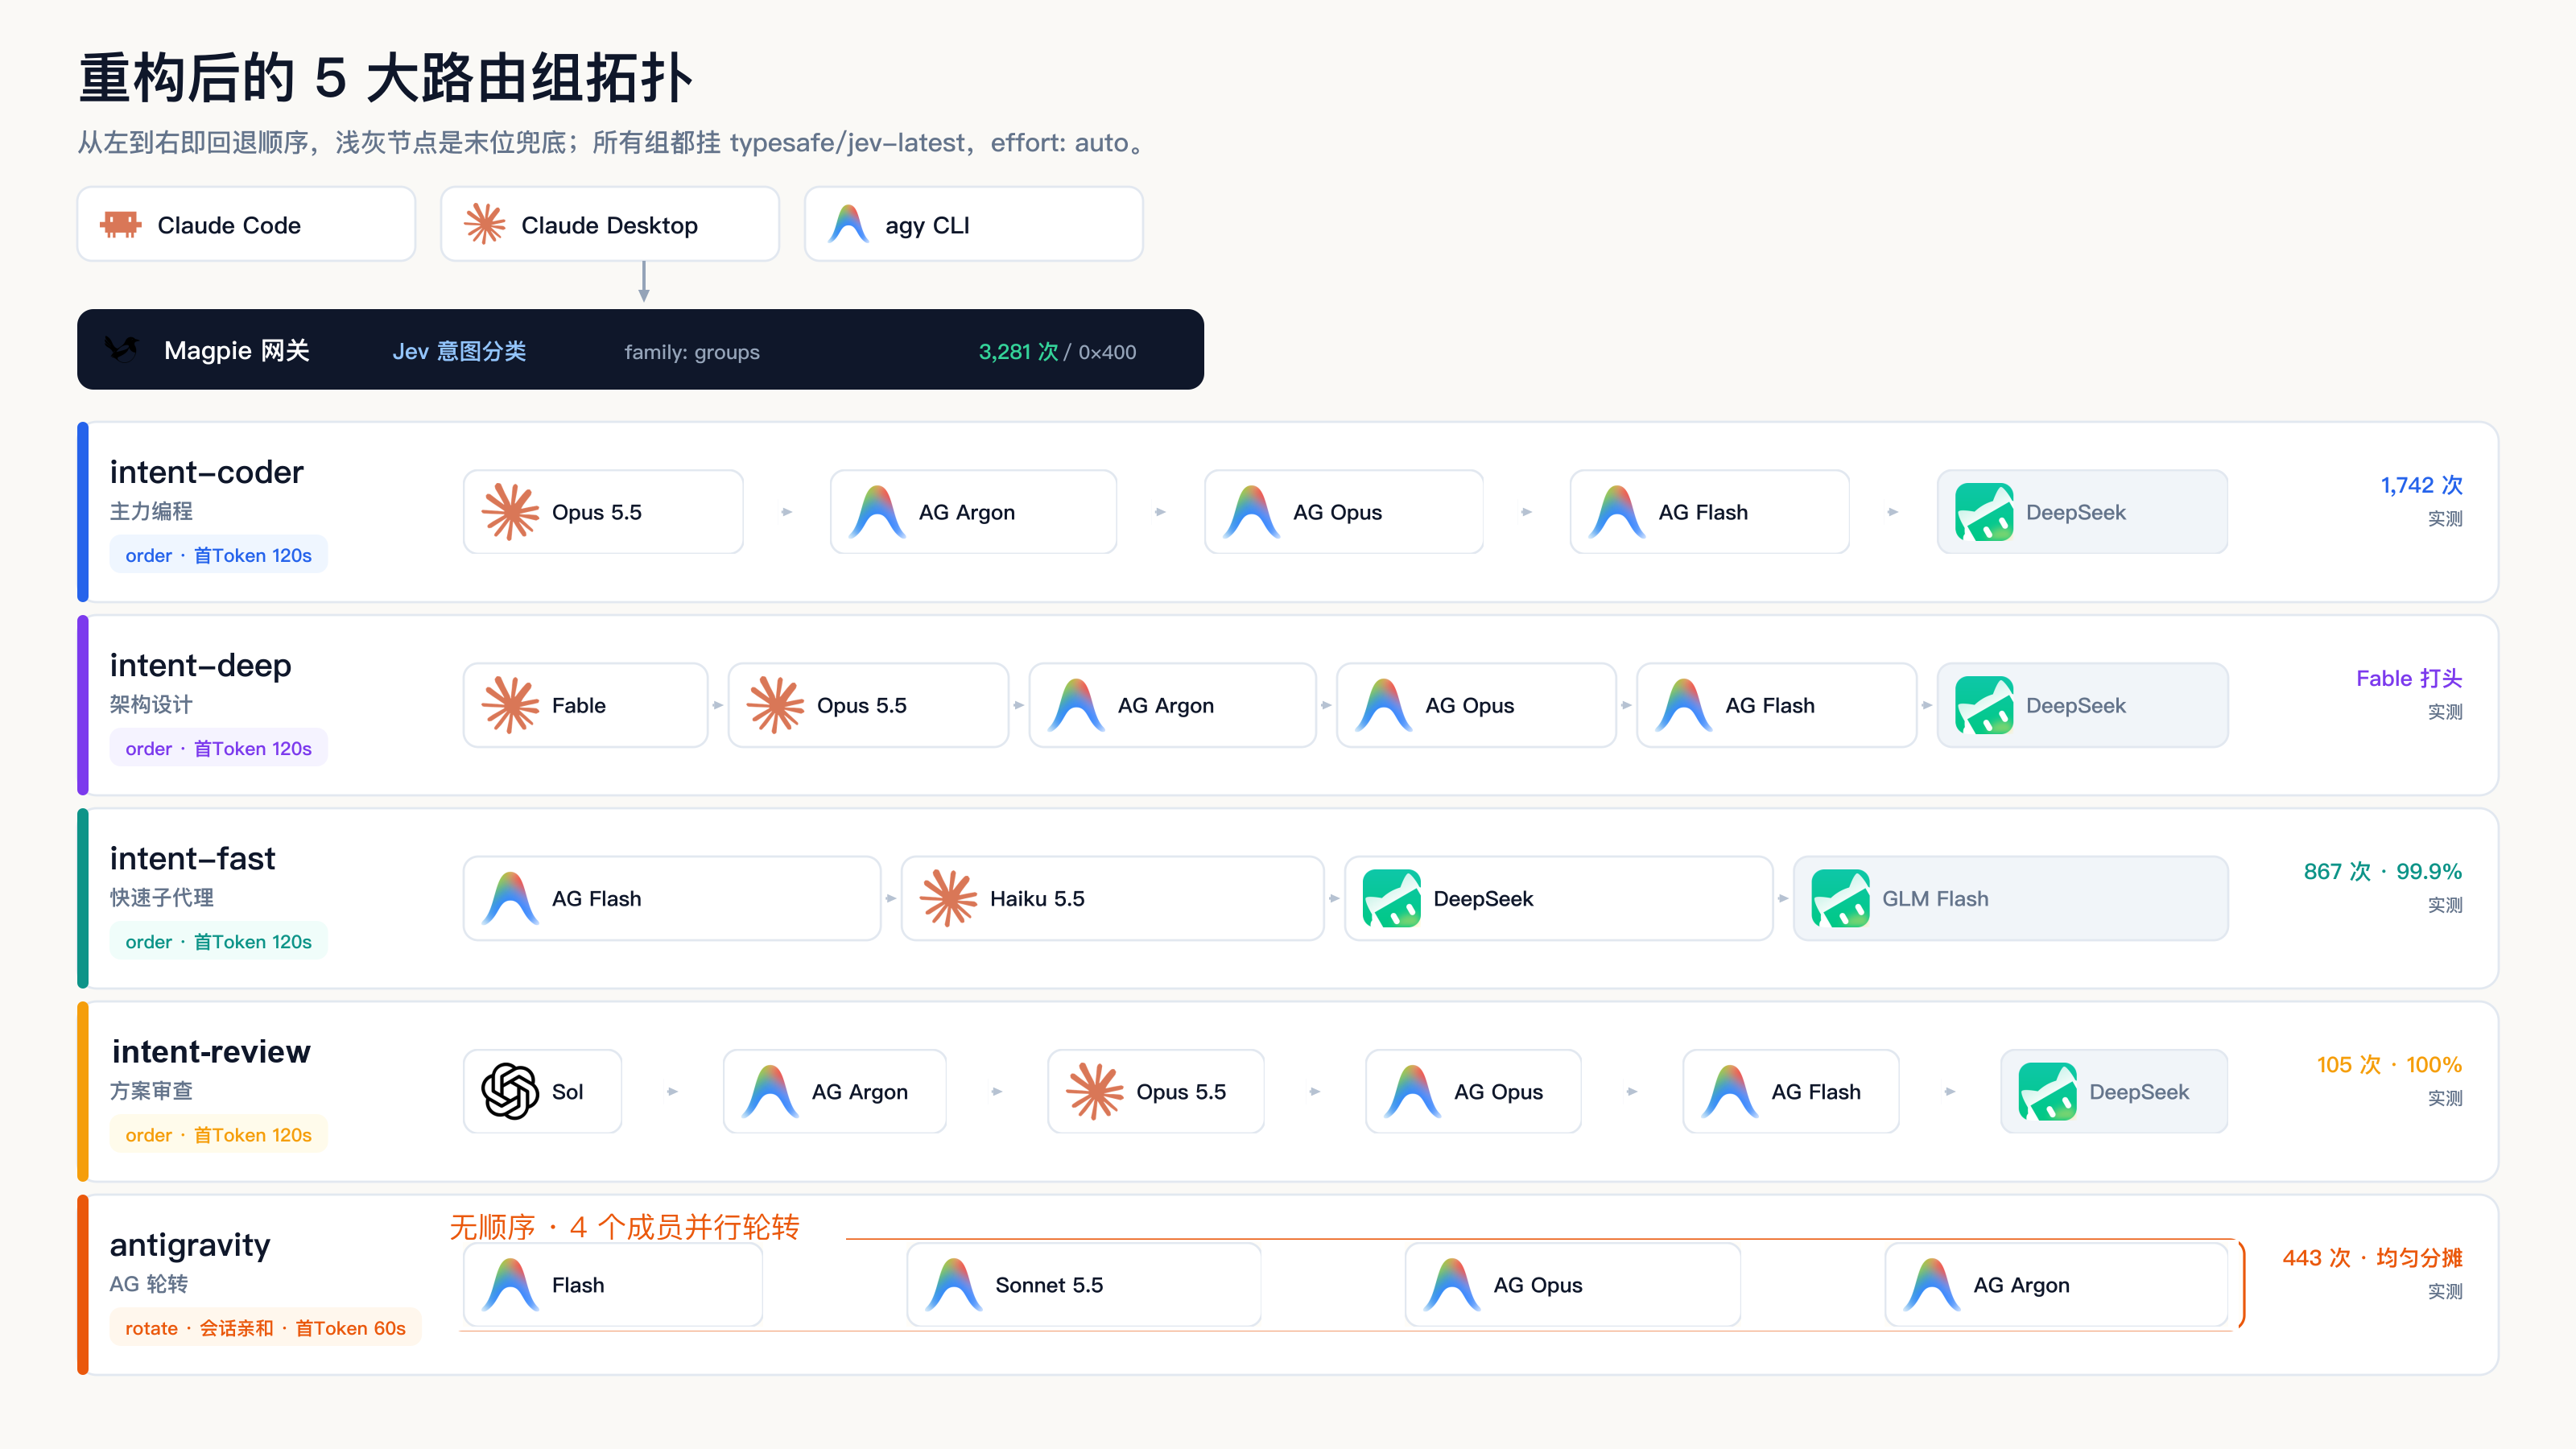
(注:各组均挂载 typesafe/jev-latest 意图分类器,effort: auto,统一声明 family: "groups" 隐藏底层 30 多个散装模型。图中次数为 10 月 21 日上午的快照,与下文全天数字的统计口径不同。)
从上面的拓扑图来看,现在的分工就很简单了。主力组和架构组负责日常写代码,Claude 扛不住了就让 Argon 和 Flash 顶上,最底下留 DeepSeek 兜底。快速组跑子代理,Flash 和 Haiku 走在最前头。那个折腾人的多账号轮换交给了专门的 antigravity 组,而审查则全权分给了 GPT-6.1-Sol。
这轮优化调整后,再次让 AI 把日志拉出来分析,终于没什么问题了。
10 月 21 日这一整天网关吞了 4,685 个请求。除了我自己敲键盘 Ctrl+C 掐掉的那 13 次,还有 1 次正常的 429 规避,其余 4,671 次全绿,一个 400 崩溃都没有。
缓存率也还过得去。Prompt Cache 读了 5.21 亿 tokens,命中率冲到了 95% 以上。
主力写代码跑了 2,000 多趟,按模型拆开是 Opus 1,057 次、Flash 785 次、DeepSeek 108 次,另有 53 次是在移除 Fable 规则之前走的 Fable。Claude 额度见底后由 Flash 接手,到了半夜连 Flash 都卡壳的时候,DeepSeek 顺手捞了 108 次,整个过程我手上的代码一行都没断过。
跑子代理的快速组打了 1,200 多次,其中 Flash 1,035 次、Haiku 186 次。专职审查的那 105 次由 Sol 一个人吃干抹净。那 4 个 Google 账号的轮转组也跑了 1,100 多次,平均摊在 4 个号上,谁也不用累死,再也没弹过退登重新输密码的弹窗。
折腾了这么多天,我算是看明白了。网关这种东西,千万别抄别人的现成配置。每个人手里买的套餐不一样,平时提问写代码的习惯也天差地别。你自己搭好之后,用上几天,一定要把调用日志翻出来看。哪些模型被截胡了,哪些额度在偷跑,日志里记得清清楚楚,适合自己才是关键。